首屏
一句话:一整本书,从译到读到学——术语一致的整书翻译流水线,双语对照的沉浸阅读,按你水平沉淀生词的学习闭环。
四个数:10 阶段翻译链路 | 850 Rust 测试+CI | 成本 −1050%·速度 3–8× | 开源 MIT
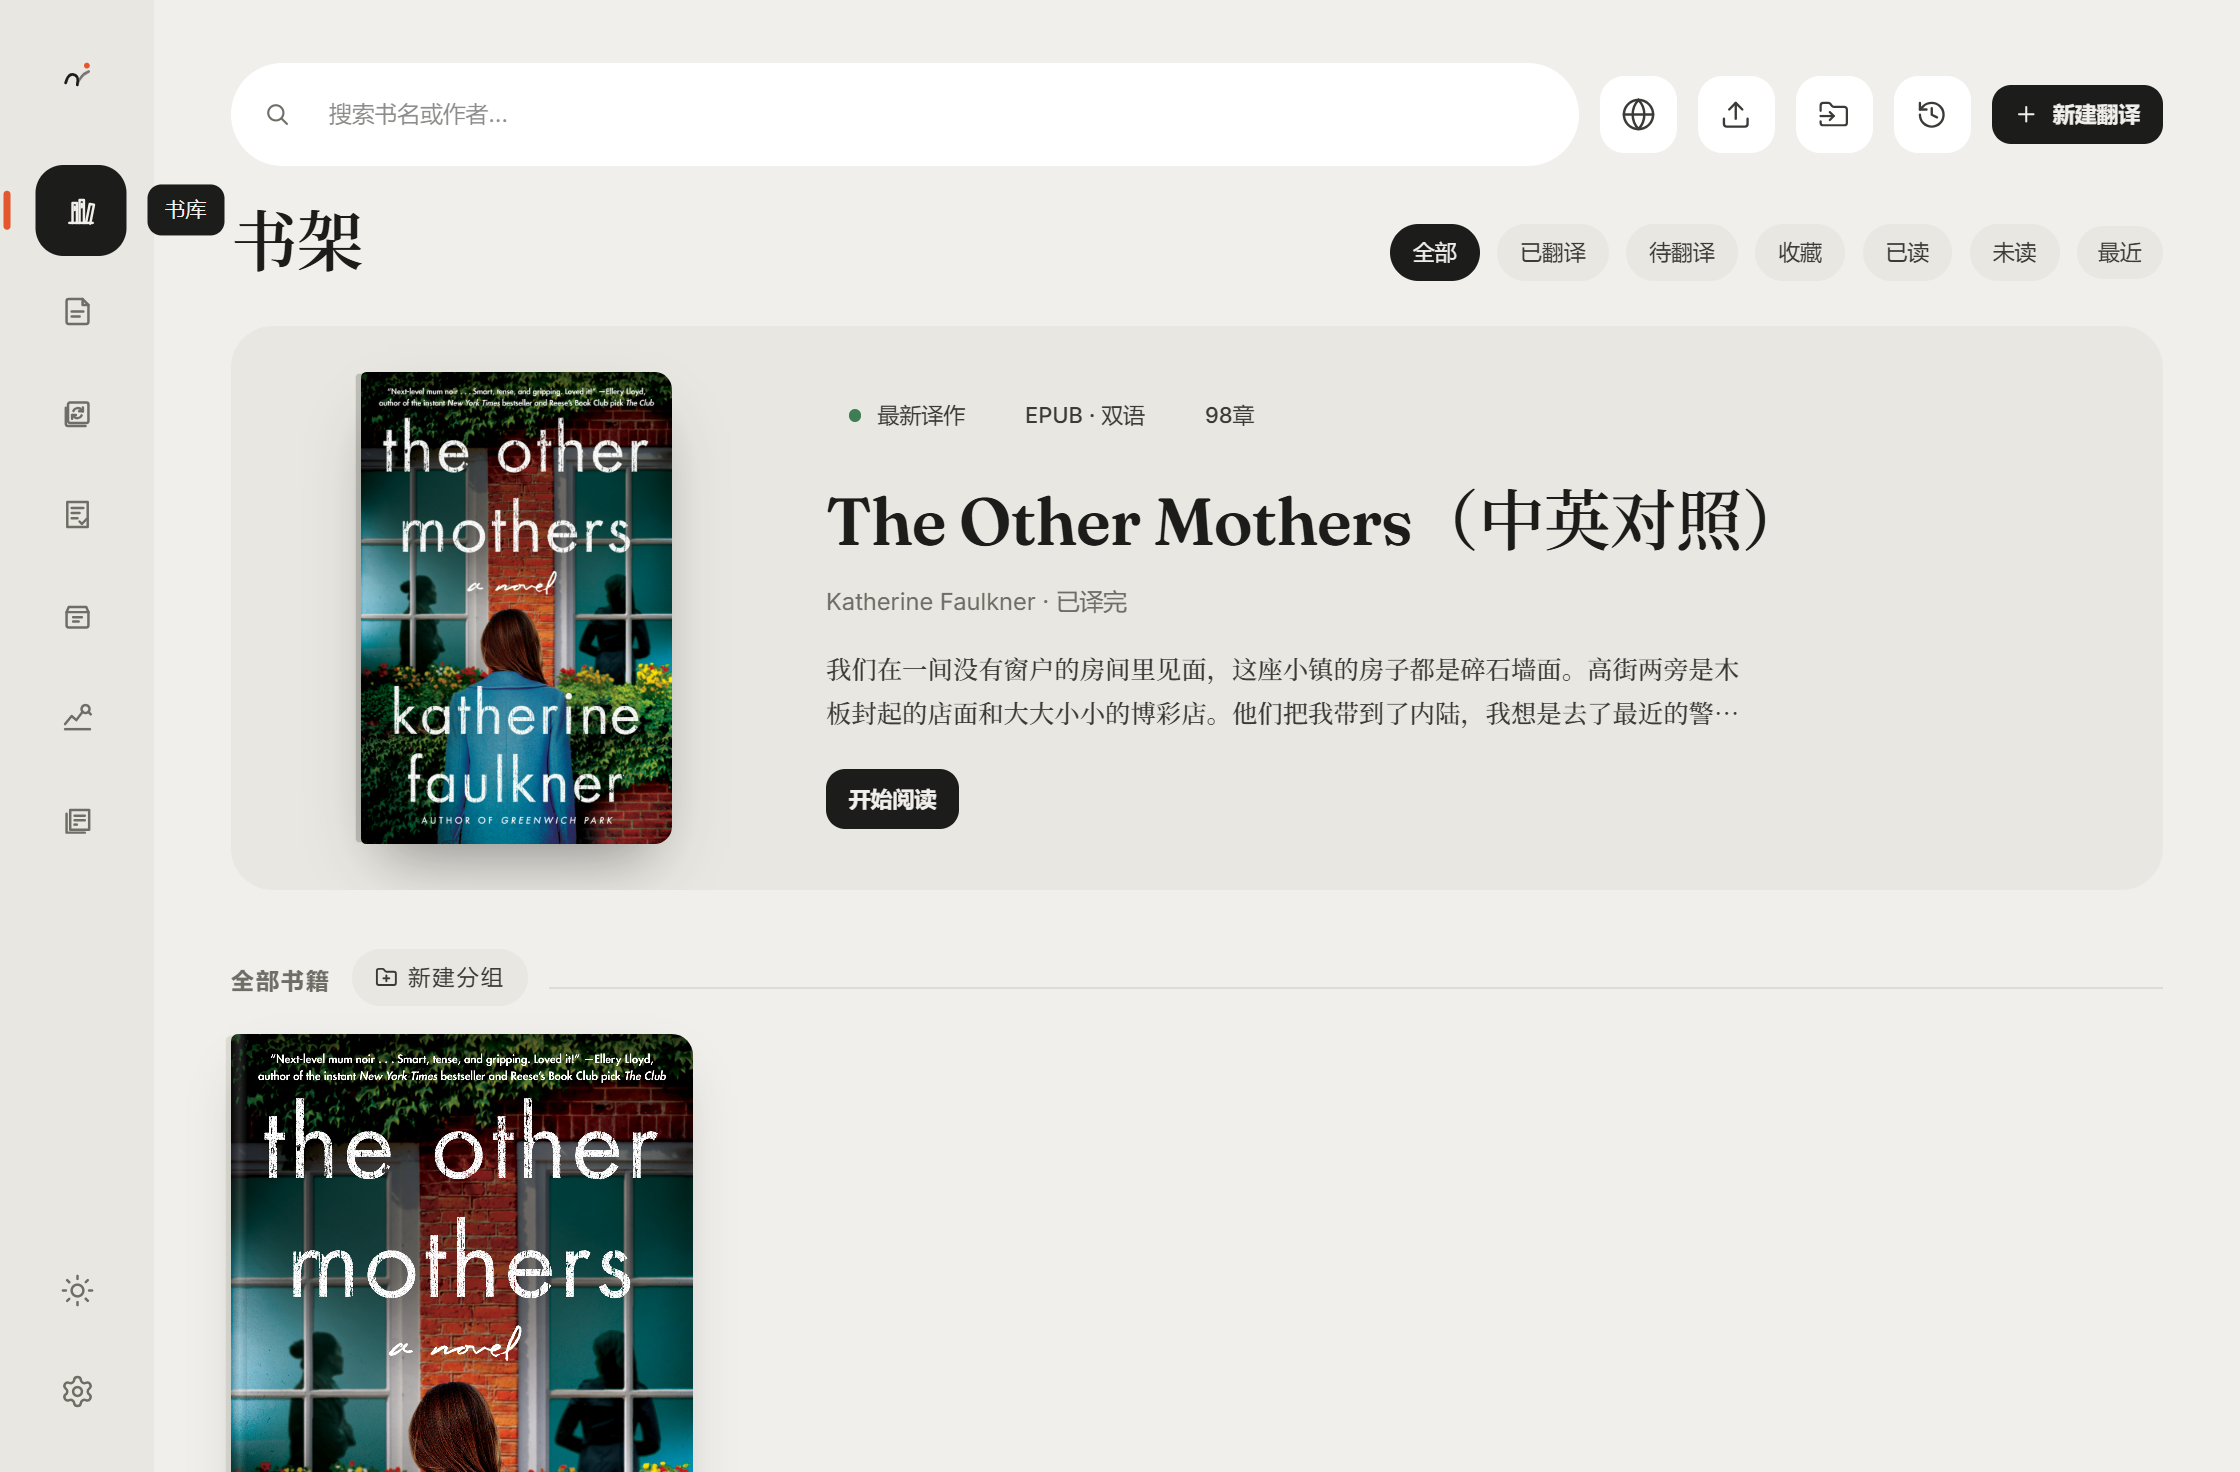
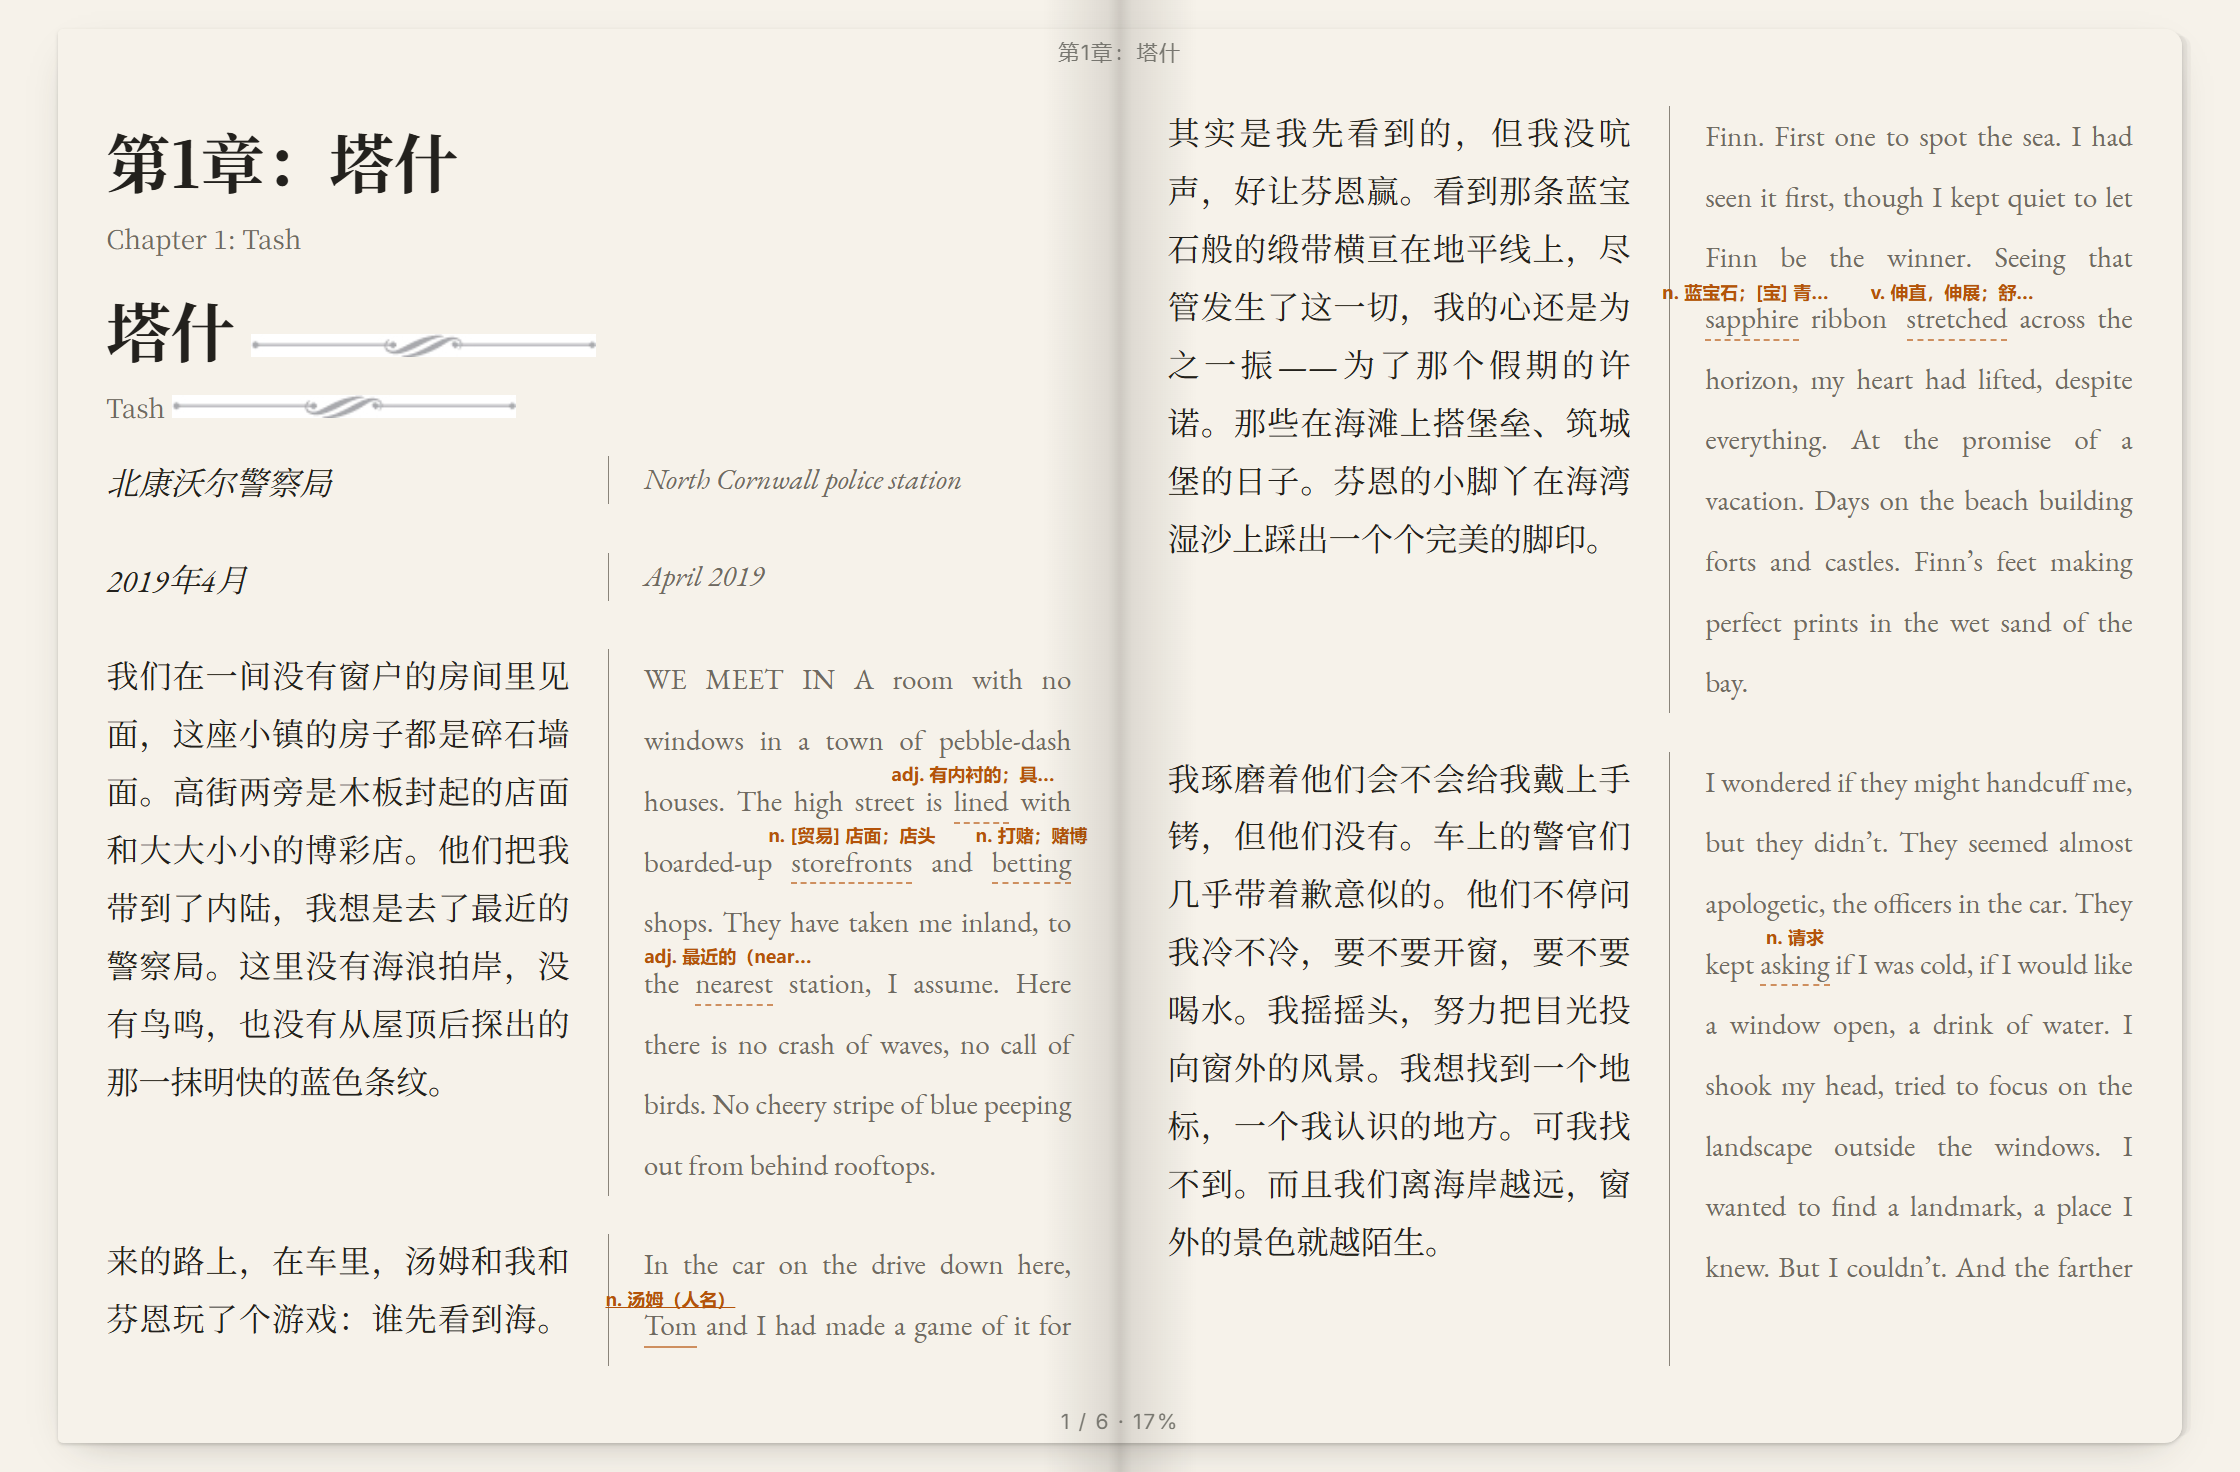
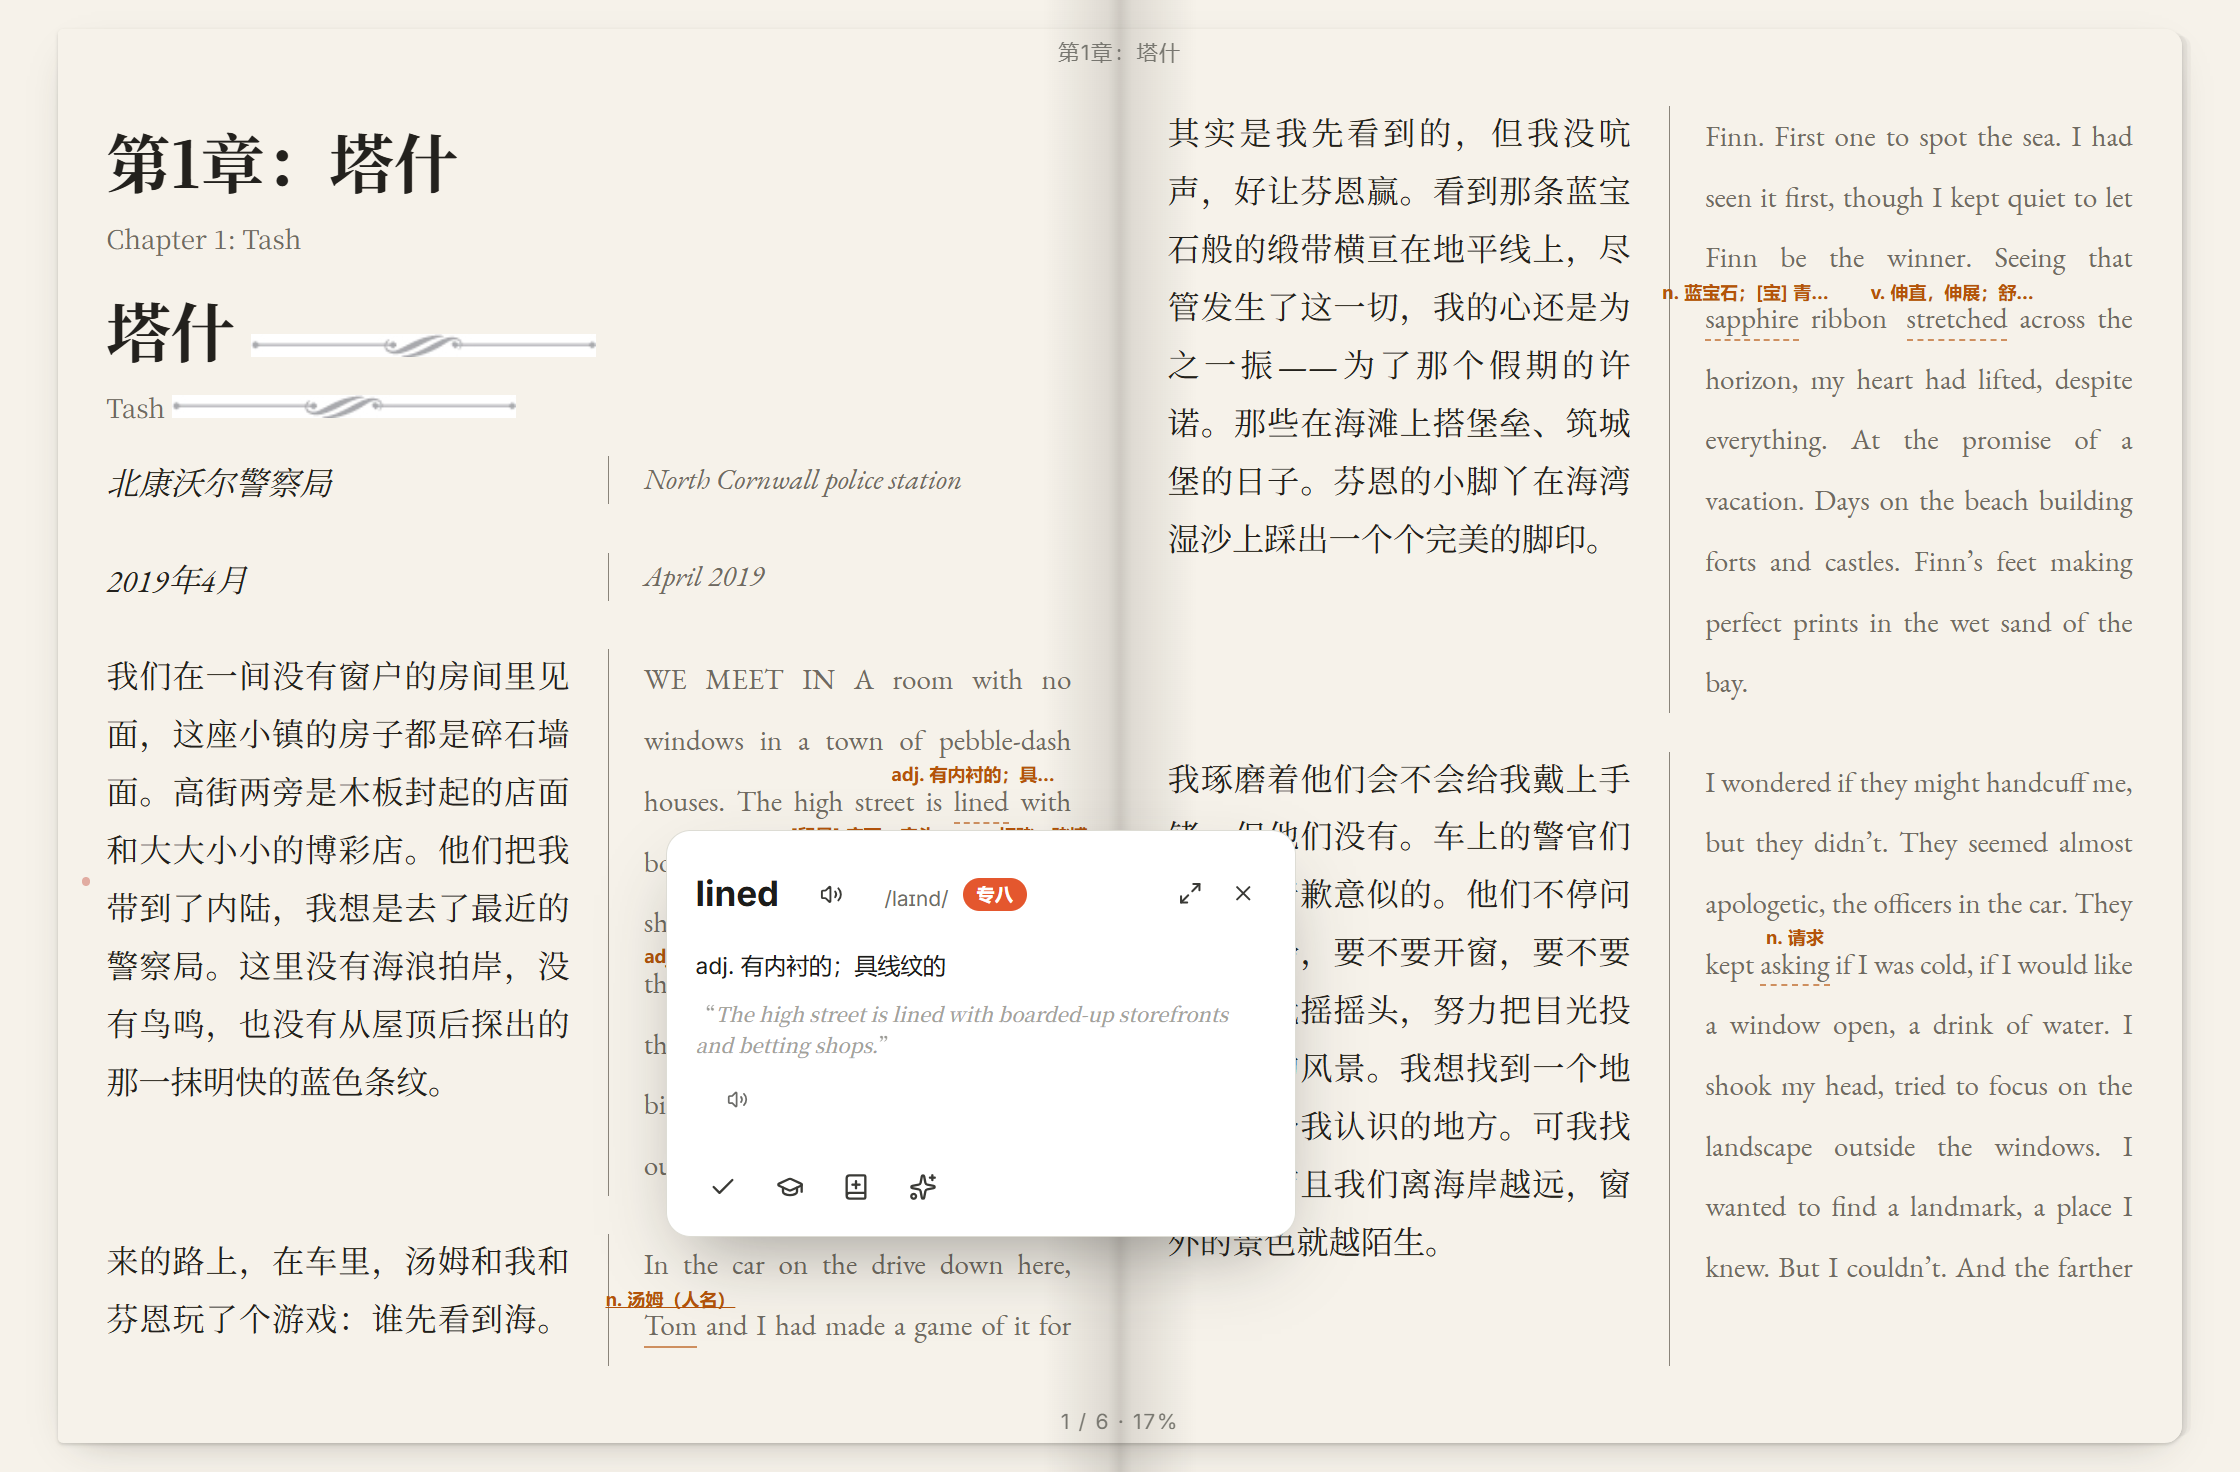
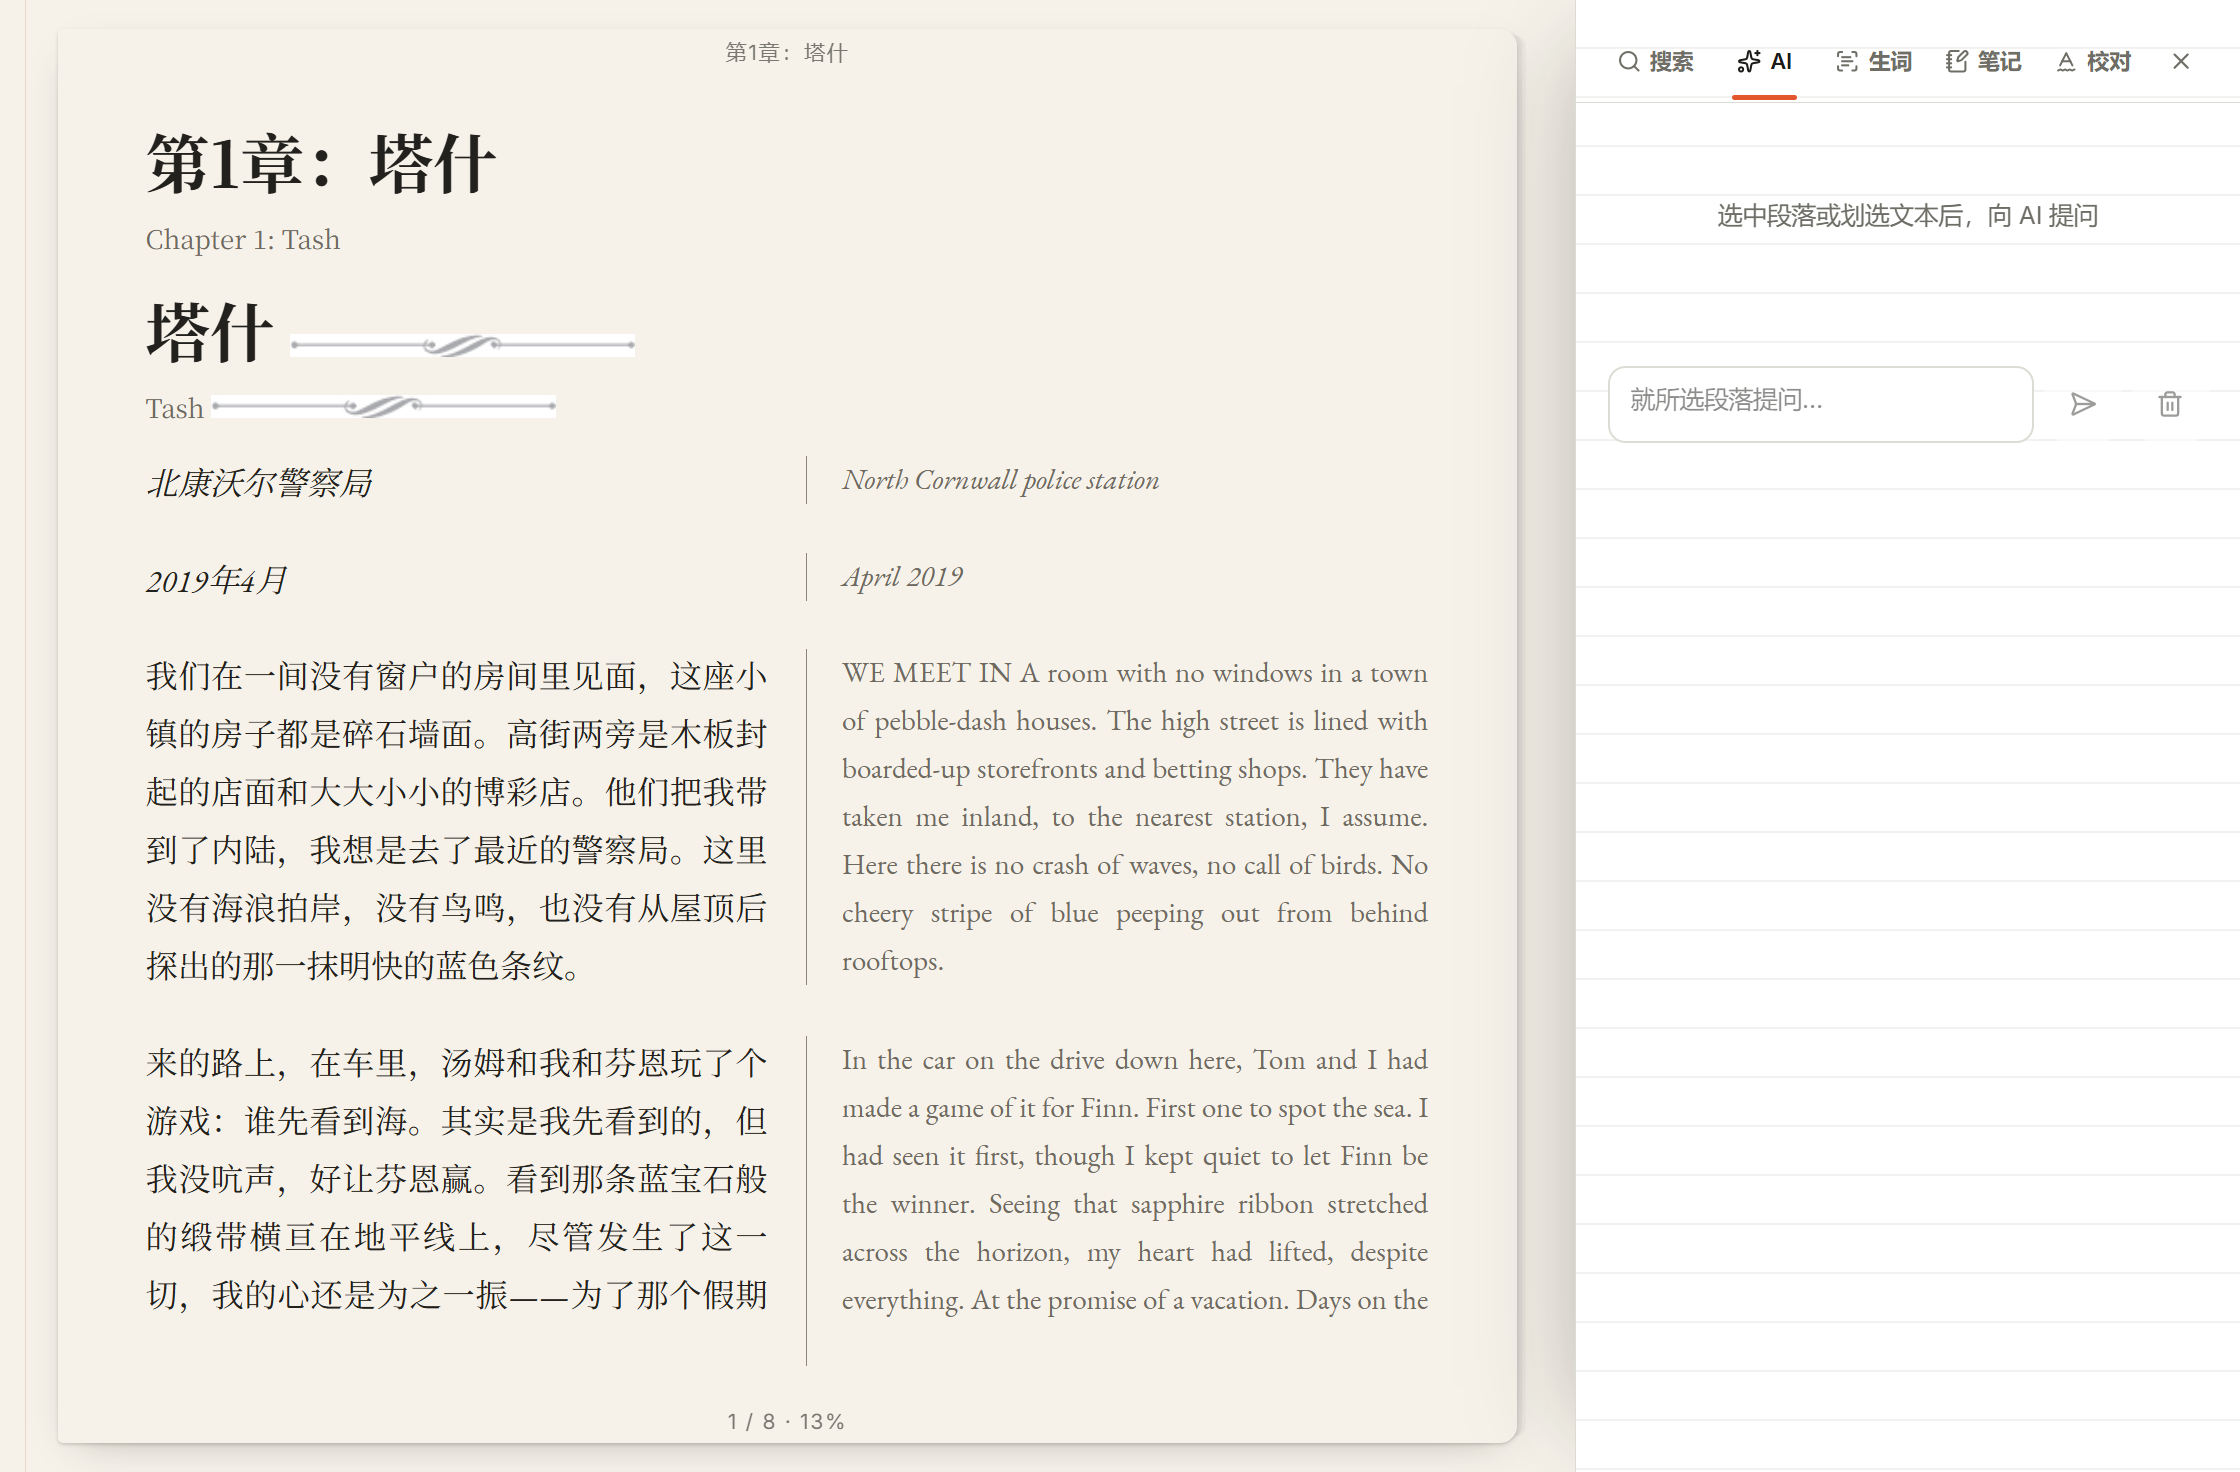
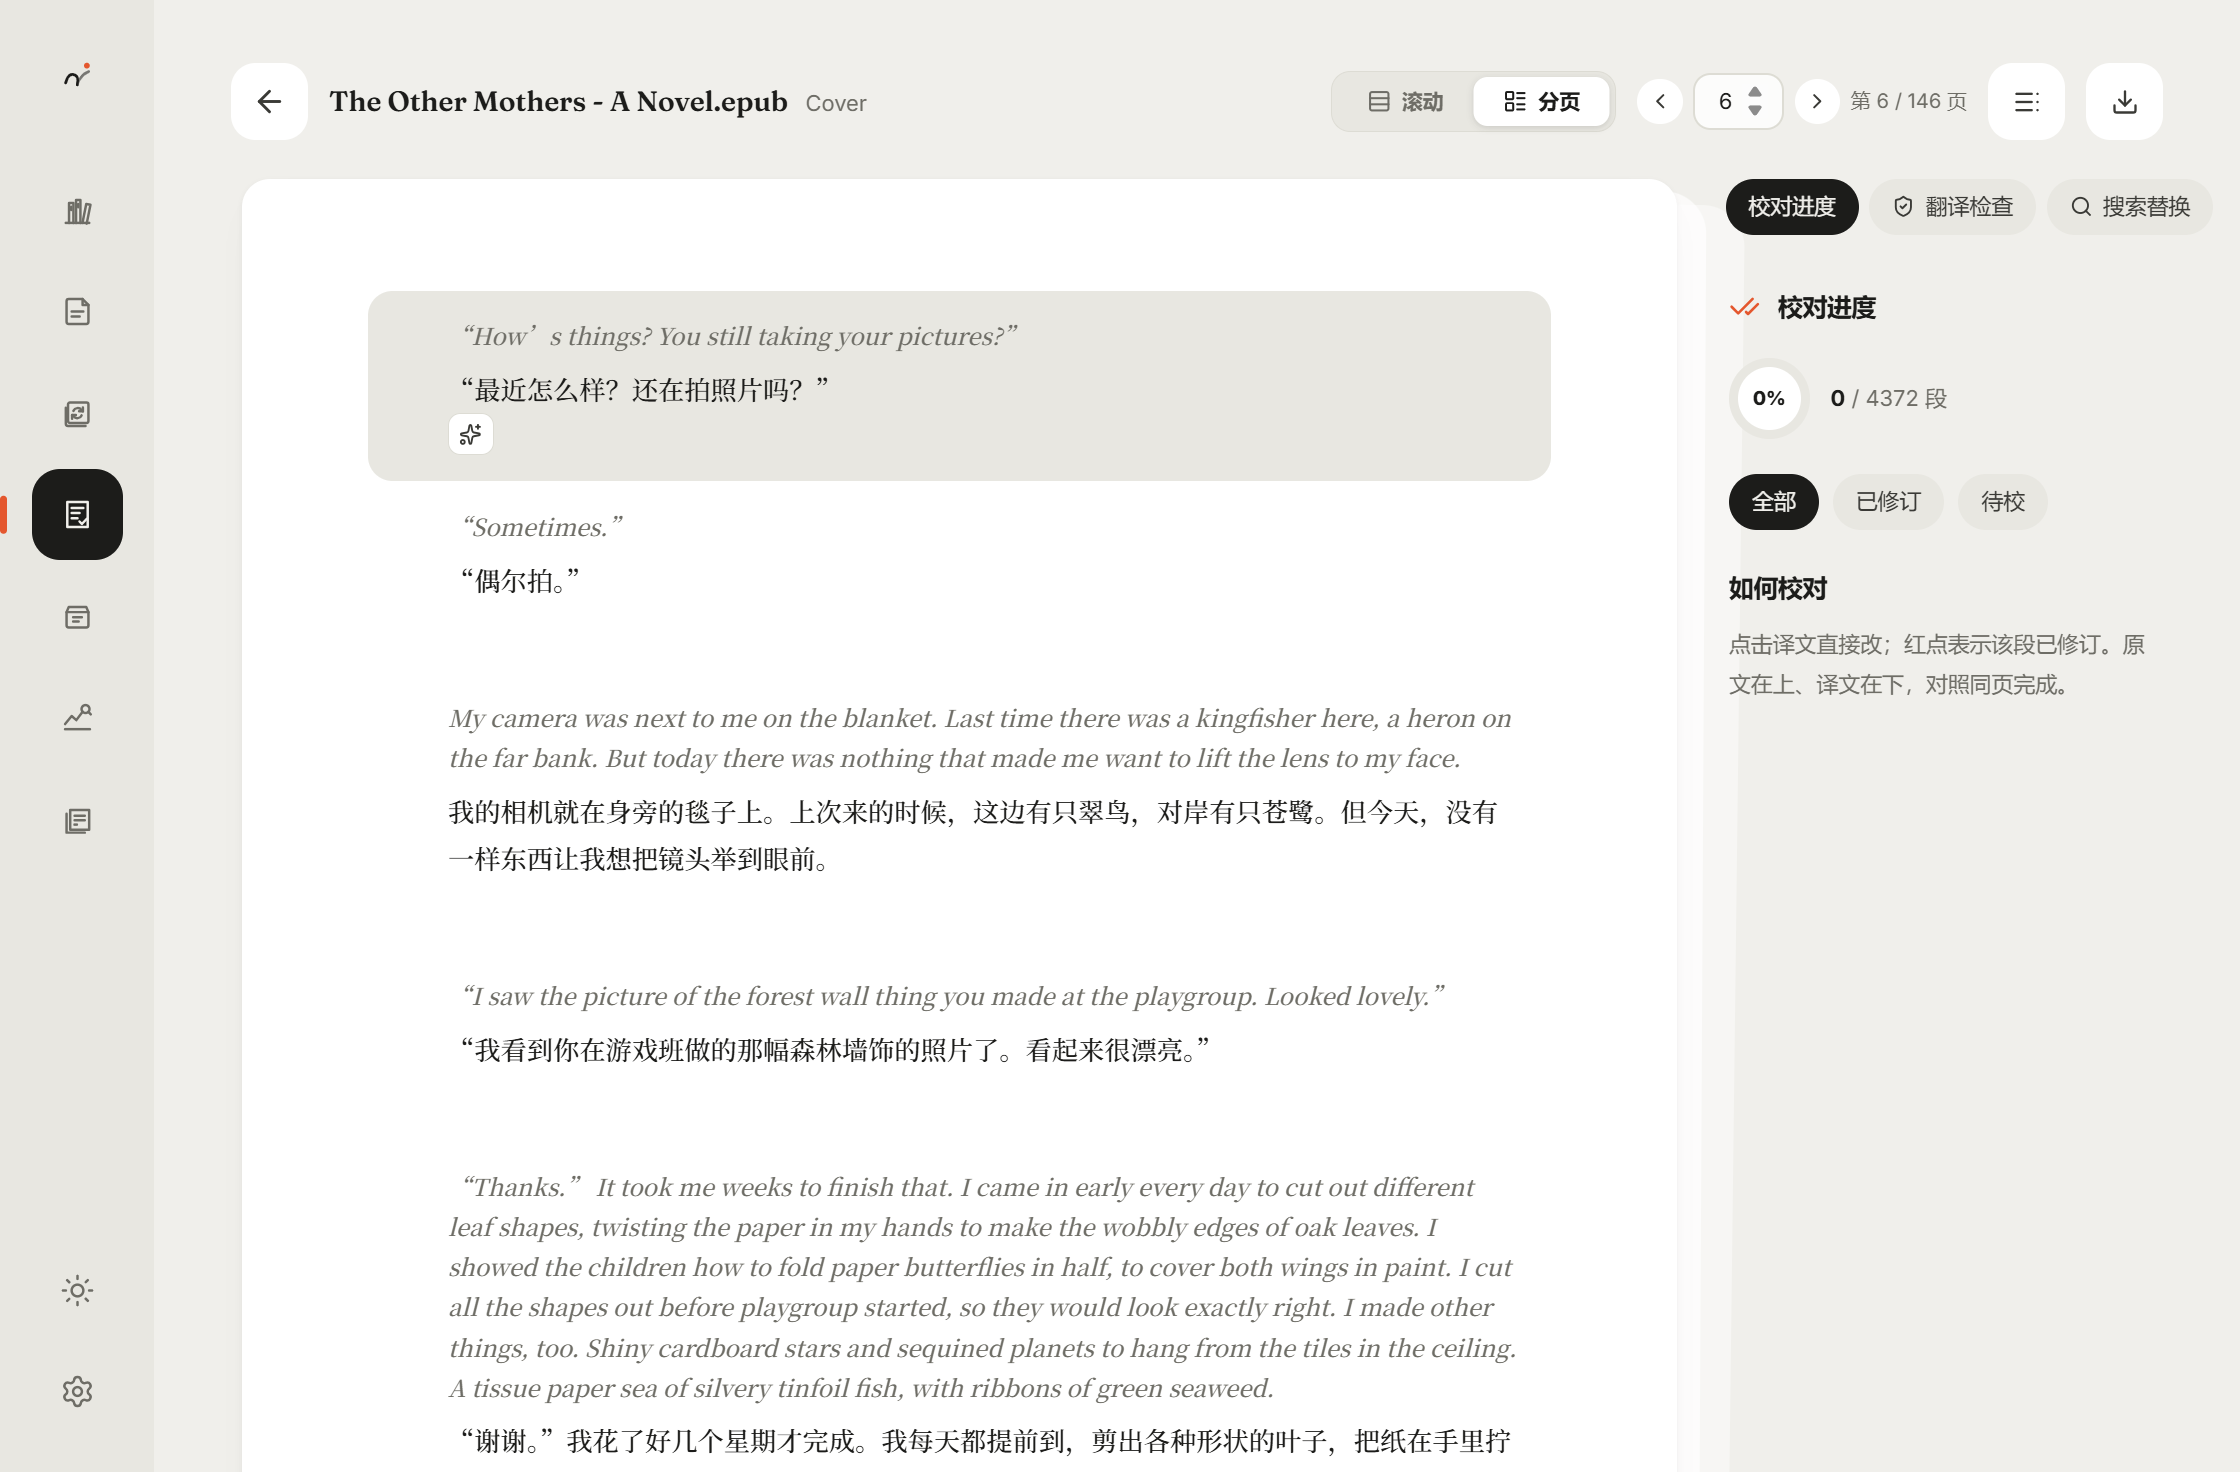
主视觉:图 1 翻译链路十阶段全景 + 书架/双语阅读截图
S0 产品形态:译·读·学,与一条由点到面的脉络
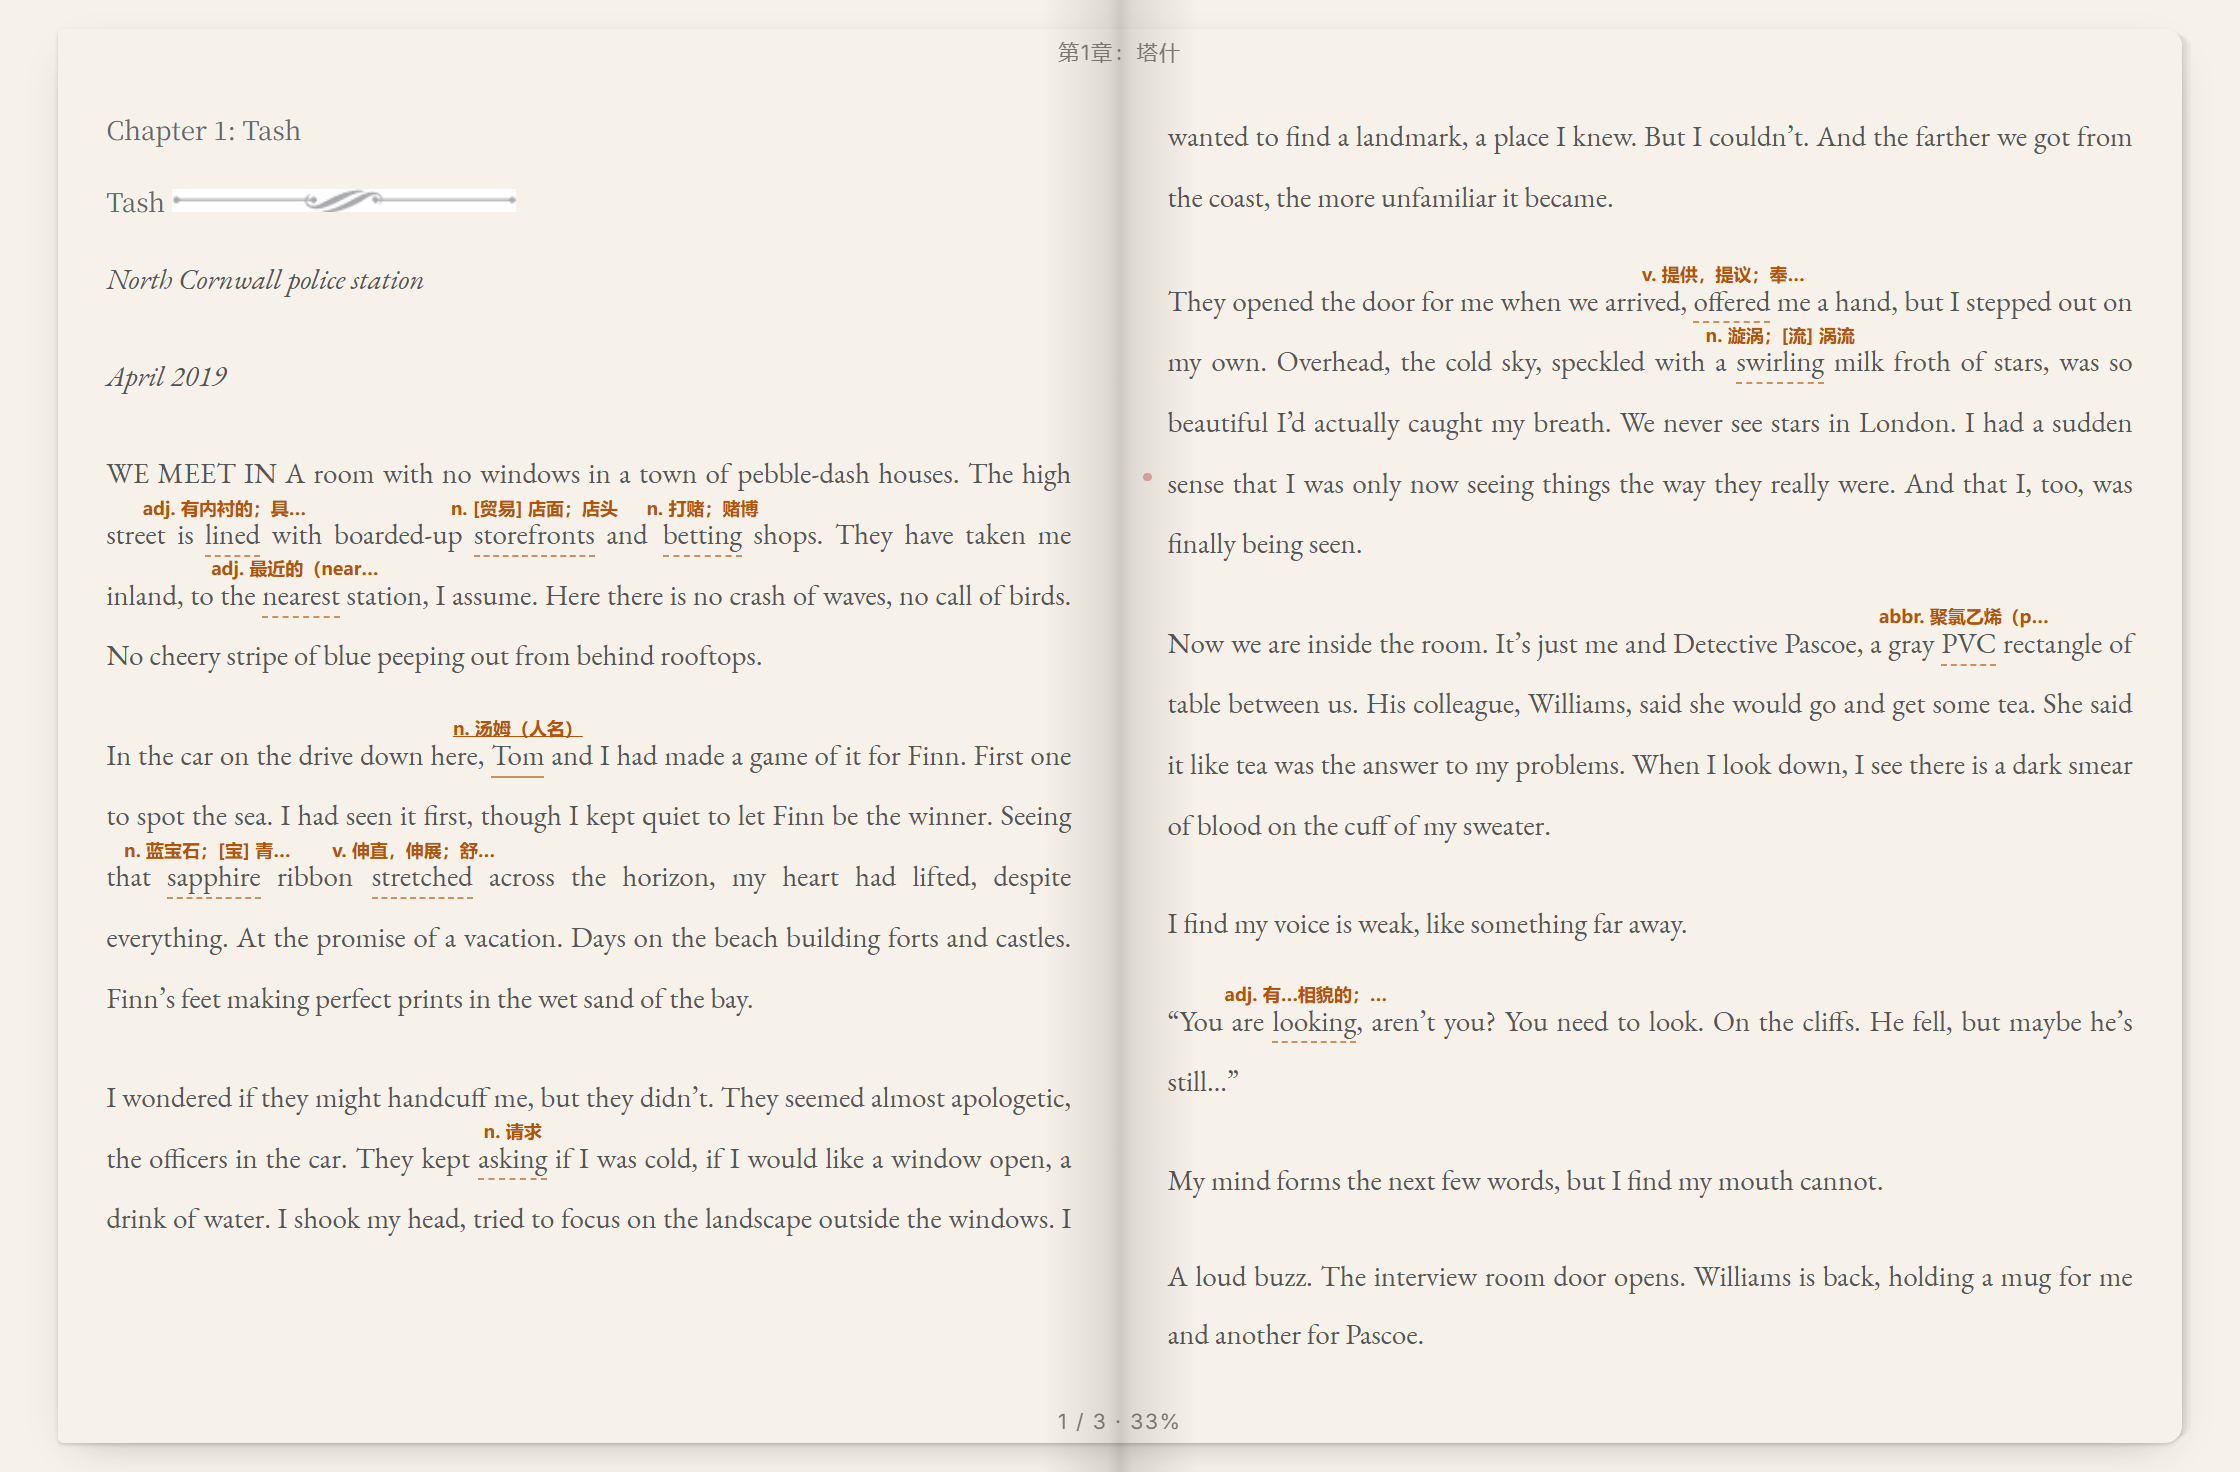
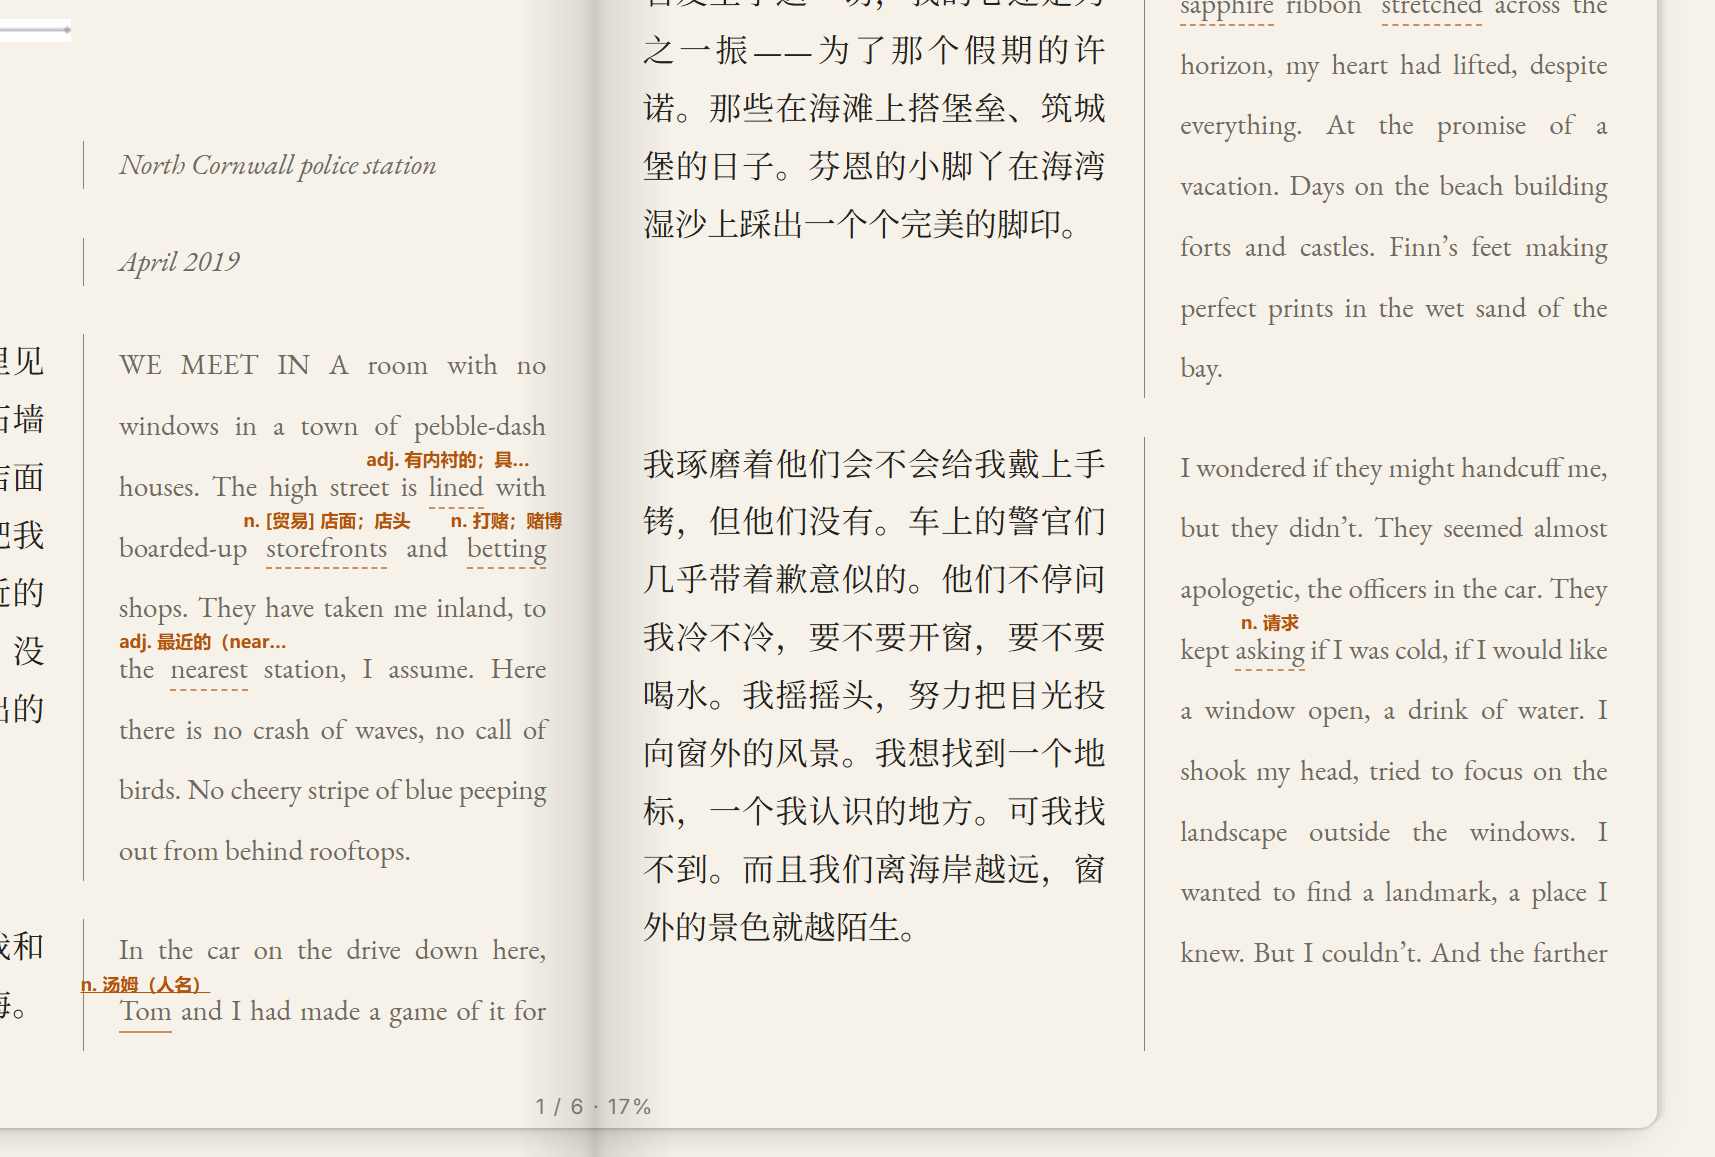
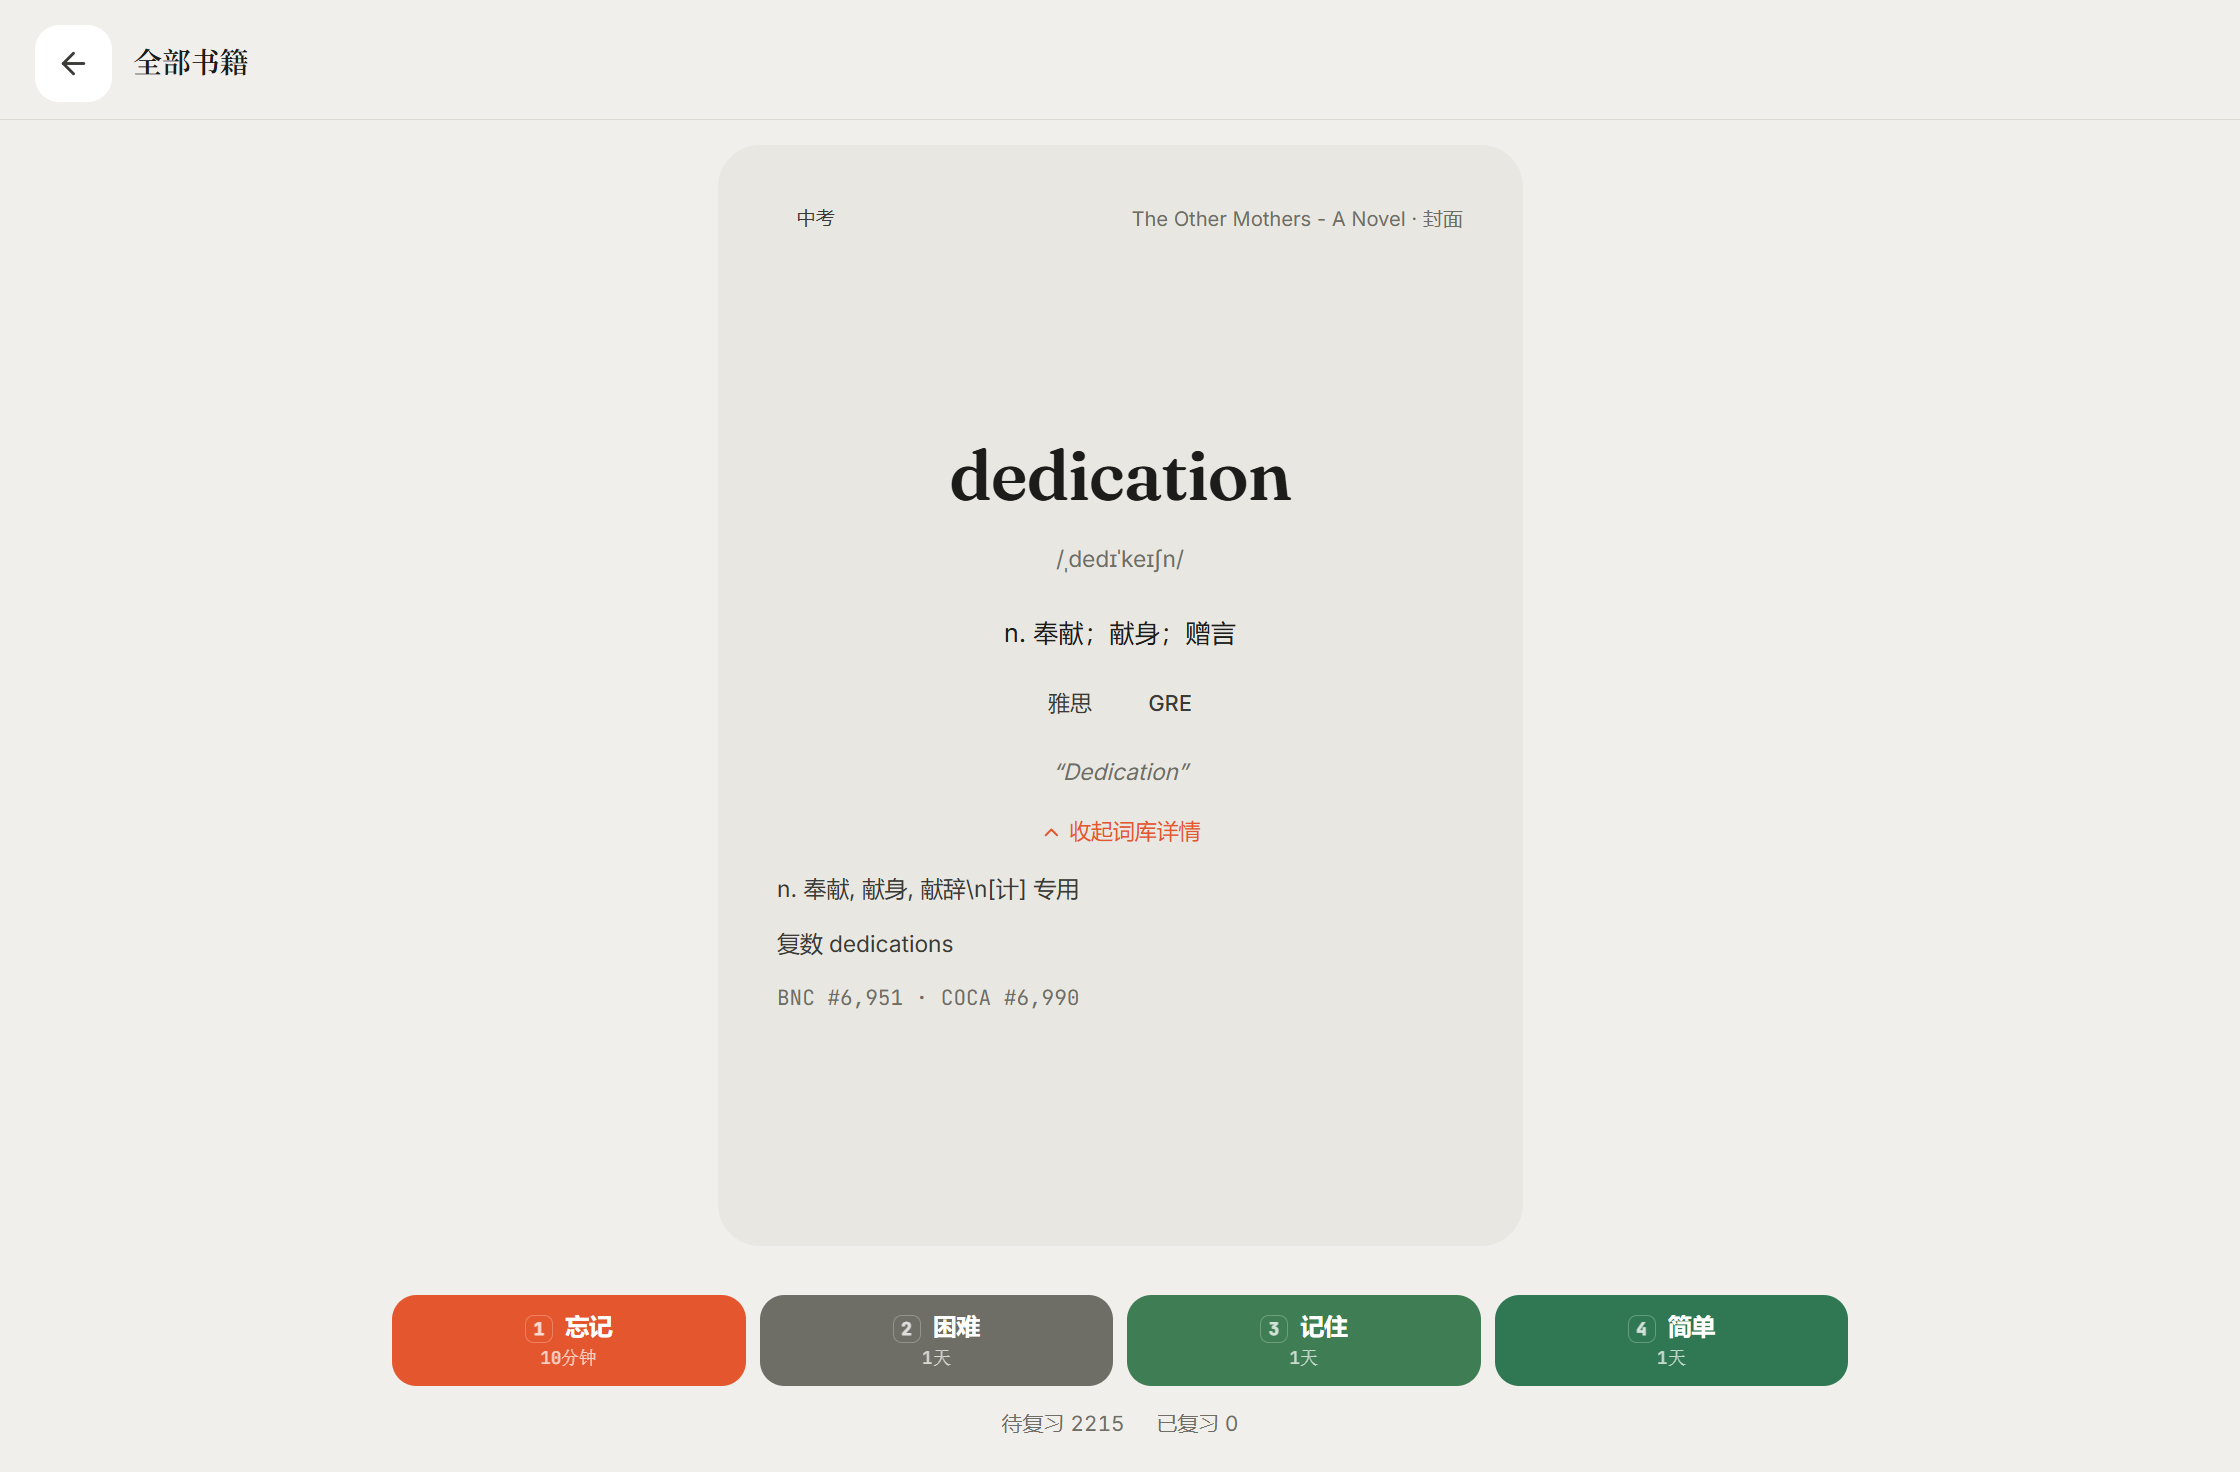
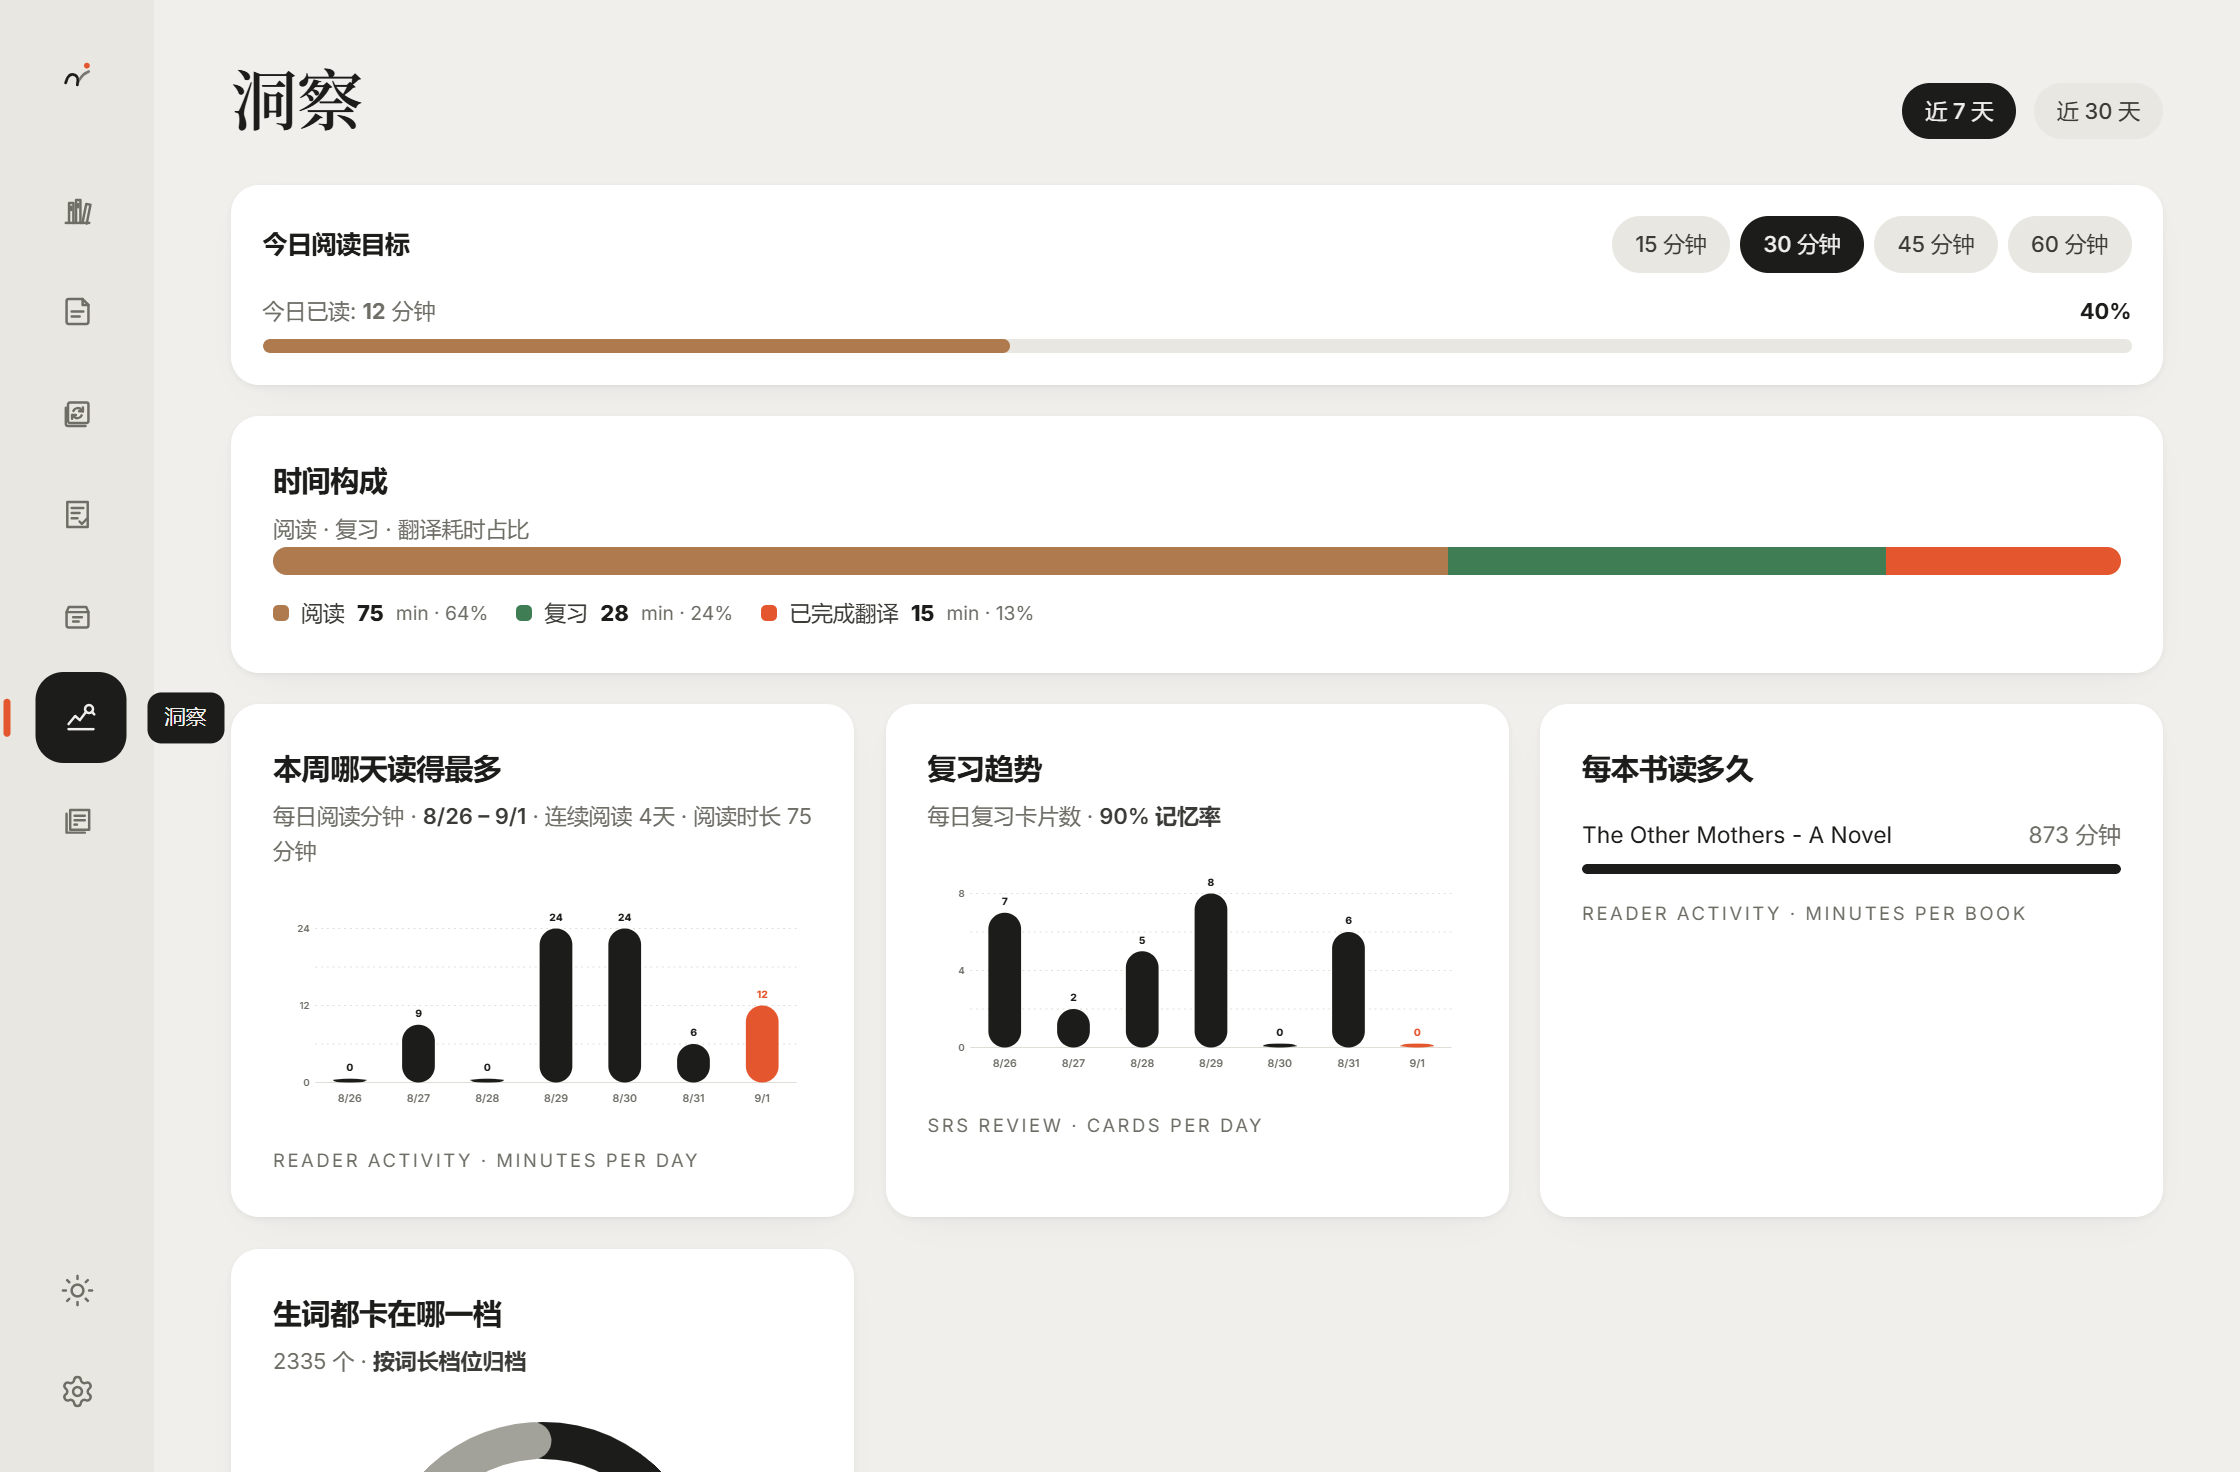
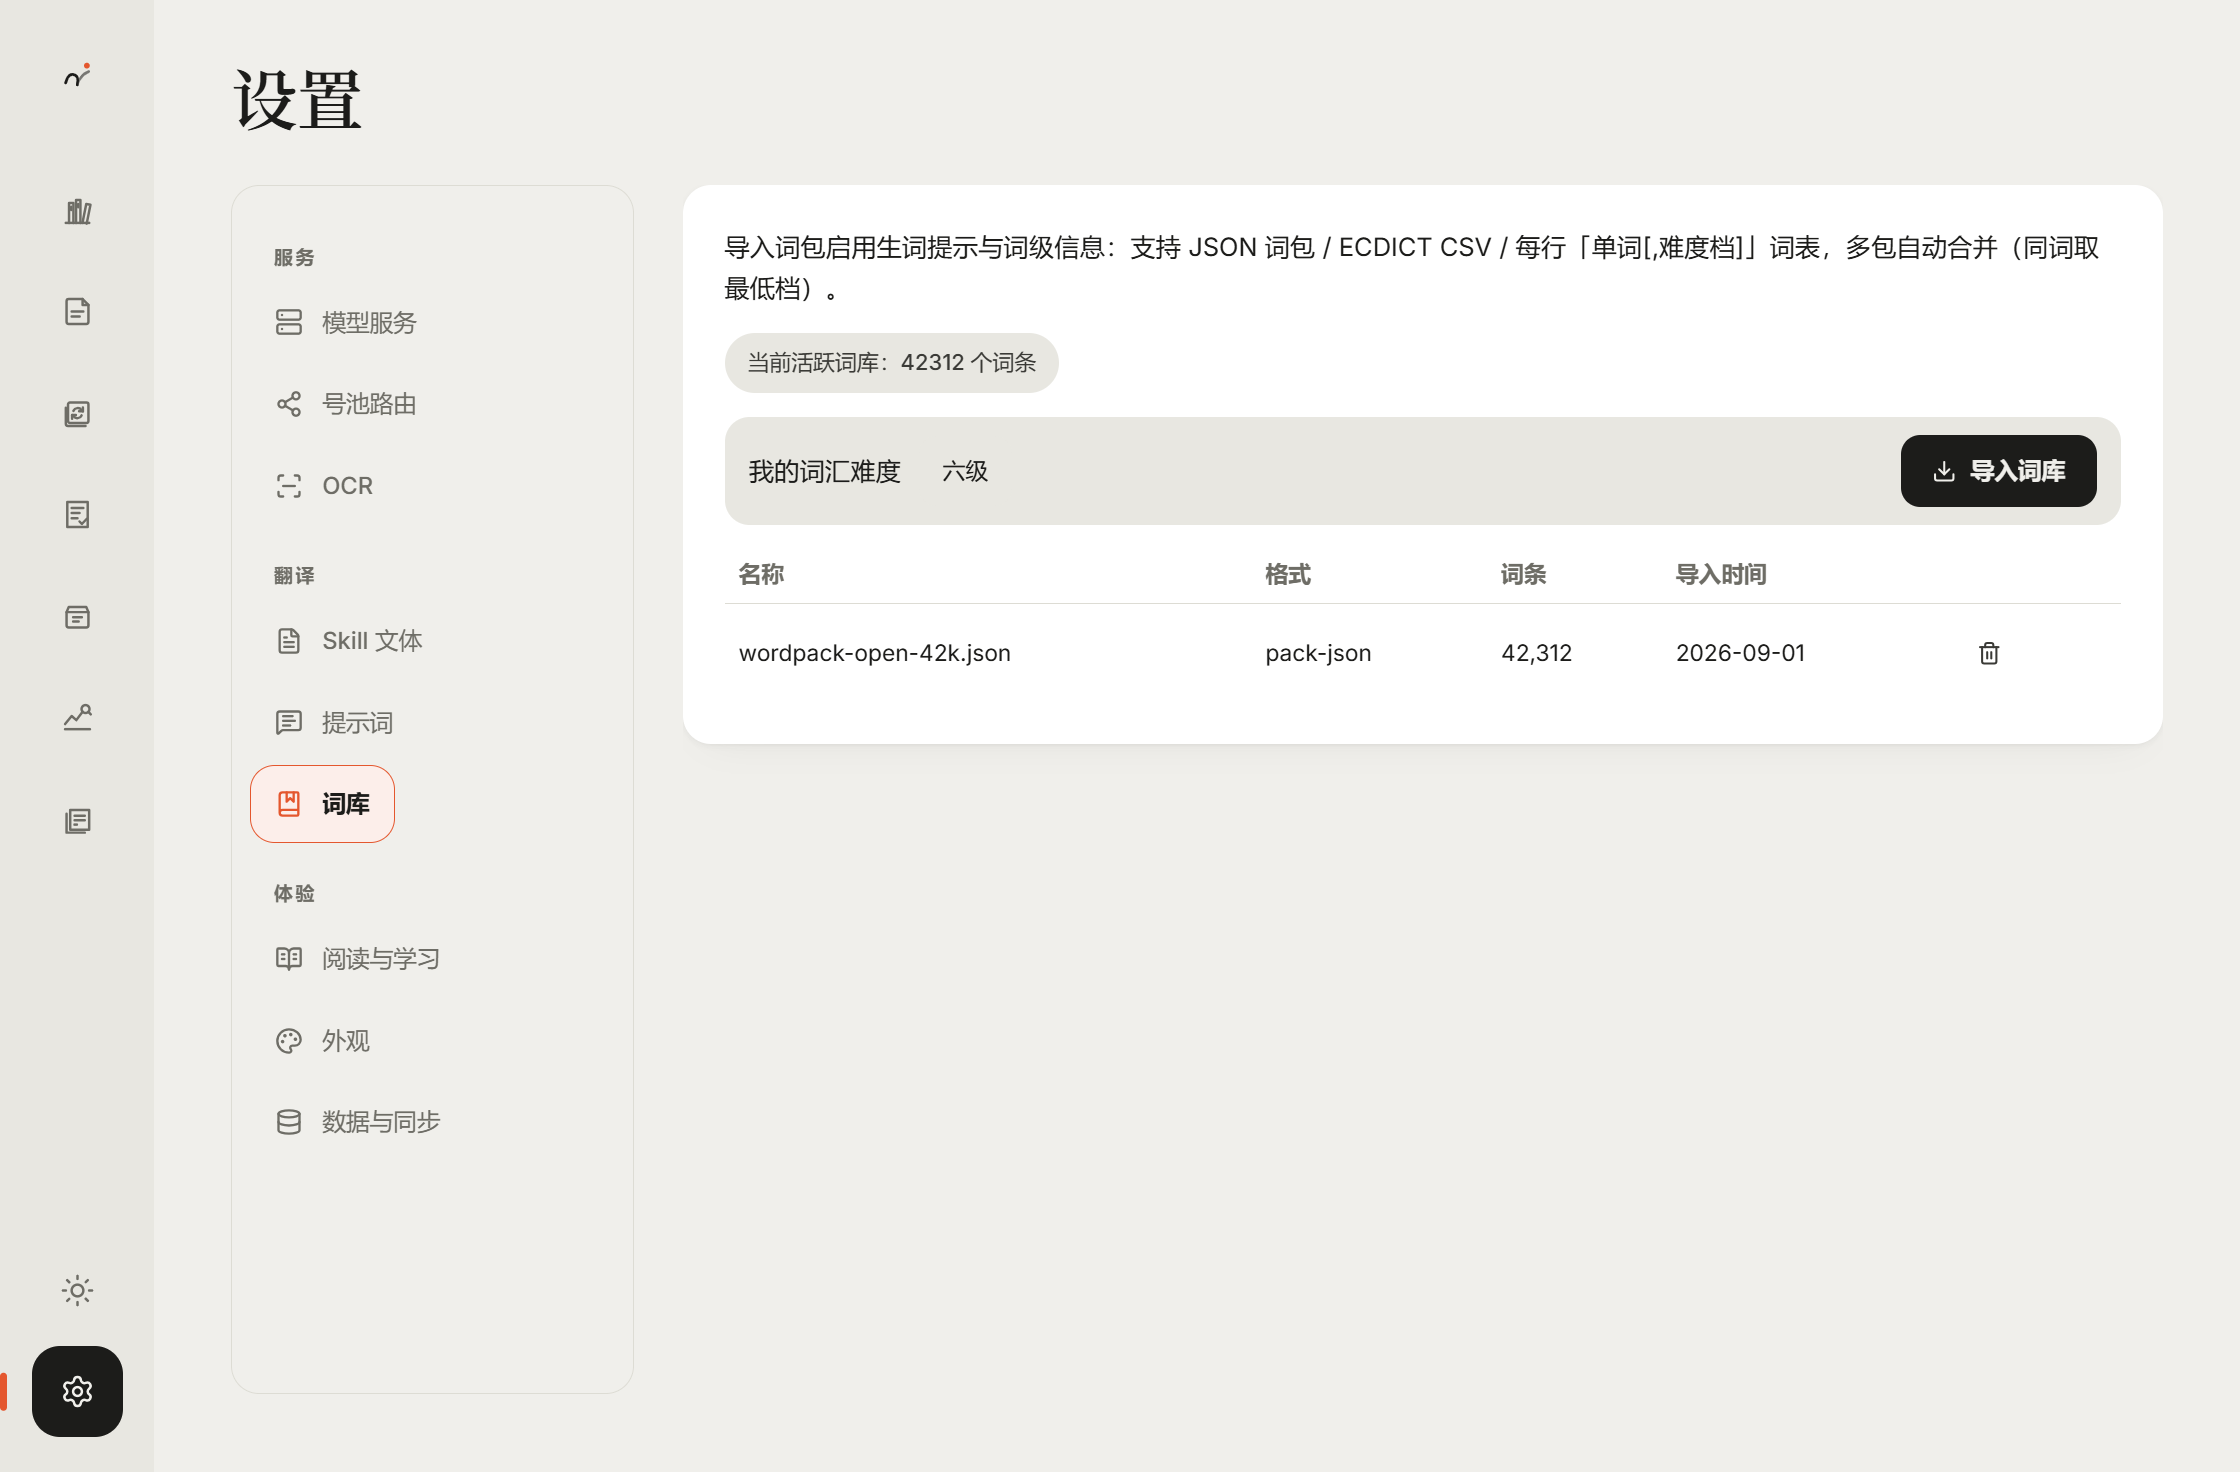
译——自研 Rust 翻译流水线:导入一本书(PDF/EPUB),走十阶段链路产出一本术语一致、结构完整、可渲染的译书。 读——双语对照整书阅读;纯英语阅读时的 WordWise 行间提词(生词在行间即时提示,不中断阅读)。 学——按你的外语水平从书中提取生词;译完即可读、可读即可学,阅读与生词沉淀不再割裂。
发展脉络(由点到面):这个项目不是一开始就规划成三模块的。它从一个点开始——先把「整书翻译」做对(术语一致、不重复计费、结构不坏);翻译做对后自然长出阅读(译完的书需要一个配得上的阅读器);阅读中又长出学习(读到的生词不该流失)。翻译→阅读→学习,是一条被真实需求推着走的路,其中翻译链路是核心与最难的部分。
S1 需求与洞察
整书翻译的痛点不是「翻不出」,而是「翻不好、翻不起、翻完就丢」:
- 术语前后不一致:同一概念在第 3 章和第 15 章译法不同,整书可读性崩塌。
- 中断=重复计费:长书翻译动辄数小时,一旦中断从头再来,token 费用翻倍。
- 结构被破坏:作者区、参考文献、表格、公式混进正文翻译,版面目全非。
- 读与学割裂:翻译完成即终点,读到的生词没有沉淀出口。
S2 市场与现状
| 现有方案 | 失效原因 |
|---|---|
| 通用翻译器 / 浏览器插件 | 句段级翻译,无整书术语一致性,无结构保护 |
| 沉浸式翻译类工具 | 面向网页双语对照,不处理整书工件与生词沉淀 |
| 生词卡 / Anki 类 | 与阅读过程割裂,需手工录入,无「按水平从书中提取」 |
| 通用 LLM 直接翻整书 | 上下文窗口装不下整书;术语漂移;中断即全废 |
空白点:整书级 + 术语一致 + 结构保护 + 译读学闭环,且成本可控。
S3 方案与规划
翻译链路十阶段(核心,全展开)
- 导入:接收 PDF / EPUB 与任务配置。
- 格式分流:PDF 统一走 OCR 预处理(布局重建 Markdown);EPUB 走结构提取(OPF/spine/nav,pandoc 转 GFM,失败回退内部抽取)。
- 领域识别:学术 front matter 两段式(结构候选提取 → 受约束 LLM 提取),作者区/机构/DOI 不混入正文;style_profile 判定文体。
- 分块:块类型 Body / Reference / ProtectedMetadata / PdfTable;参考文献与保护块不走正文翻译。
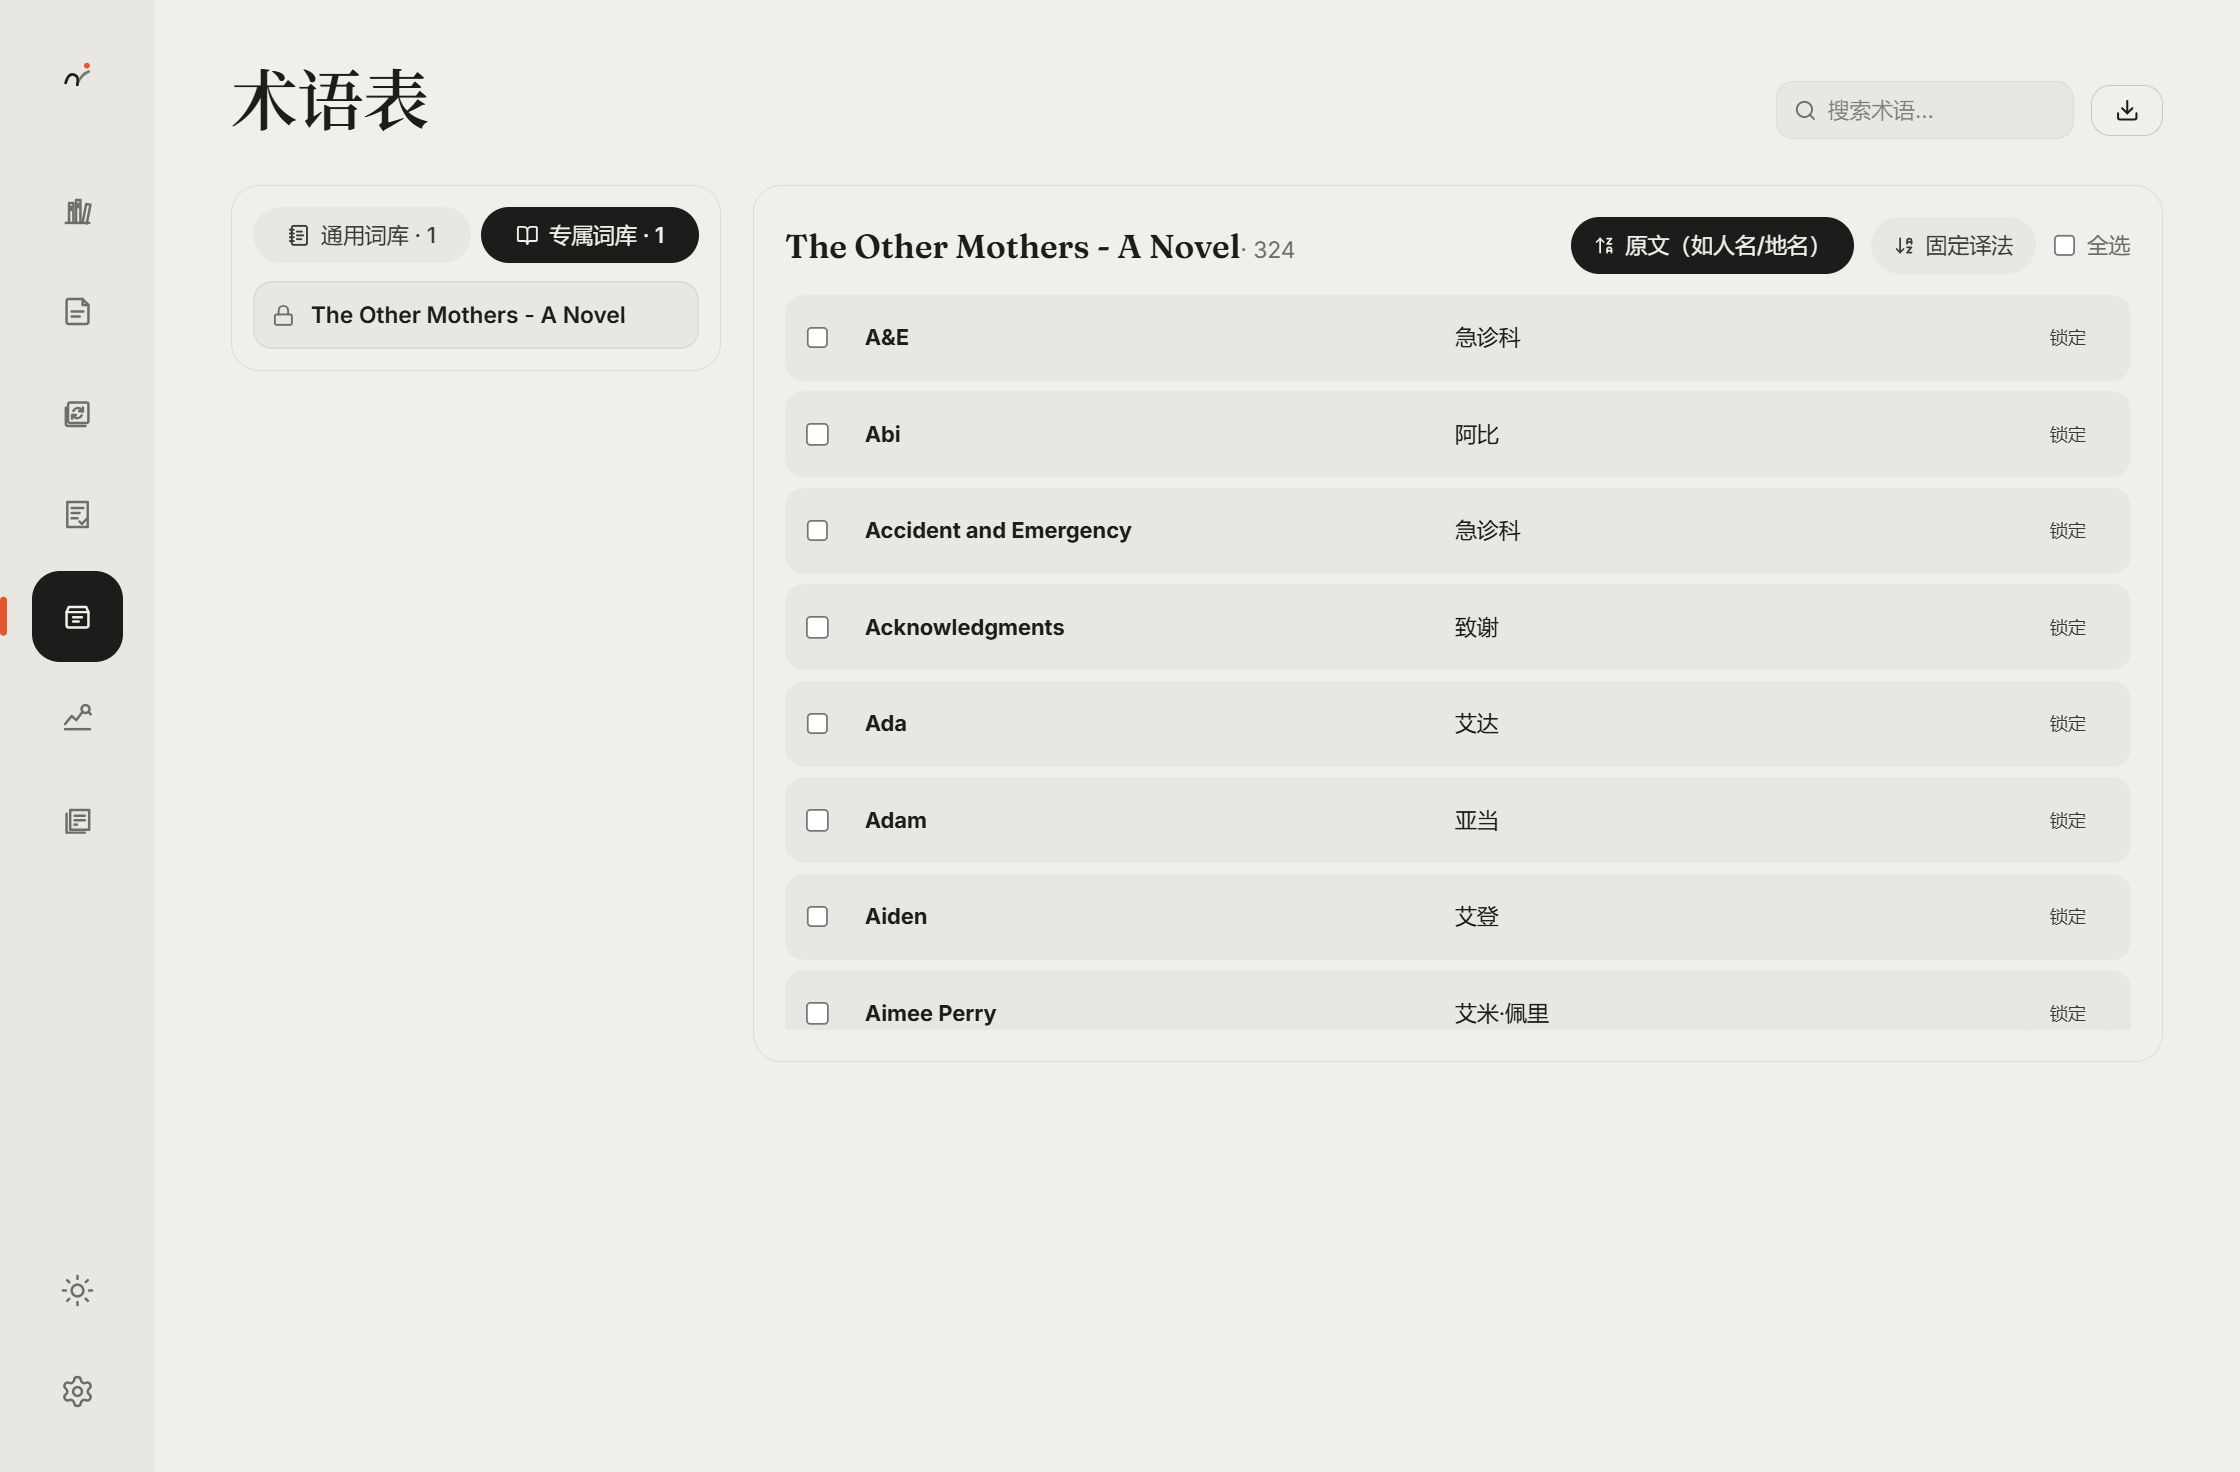
- NER 术语预提取:双层术语资源——静态术语表 + 动态术语沉淀;预提取进入正式资源层而非仅靠 prompt 暗示。
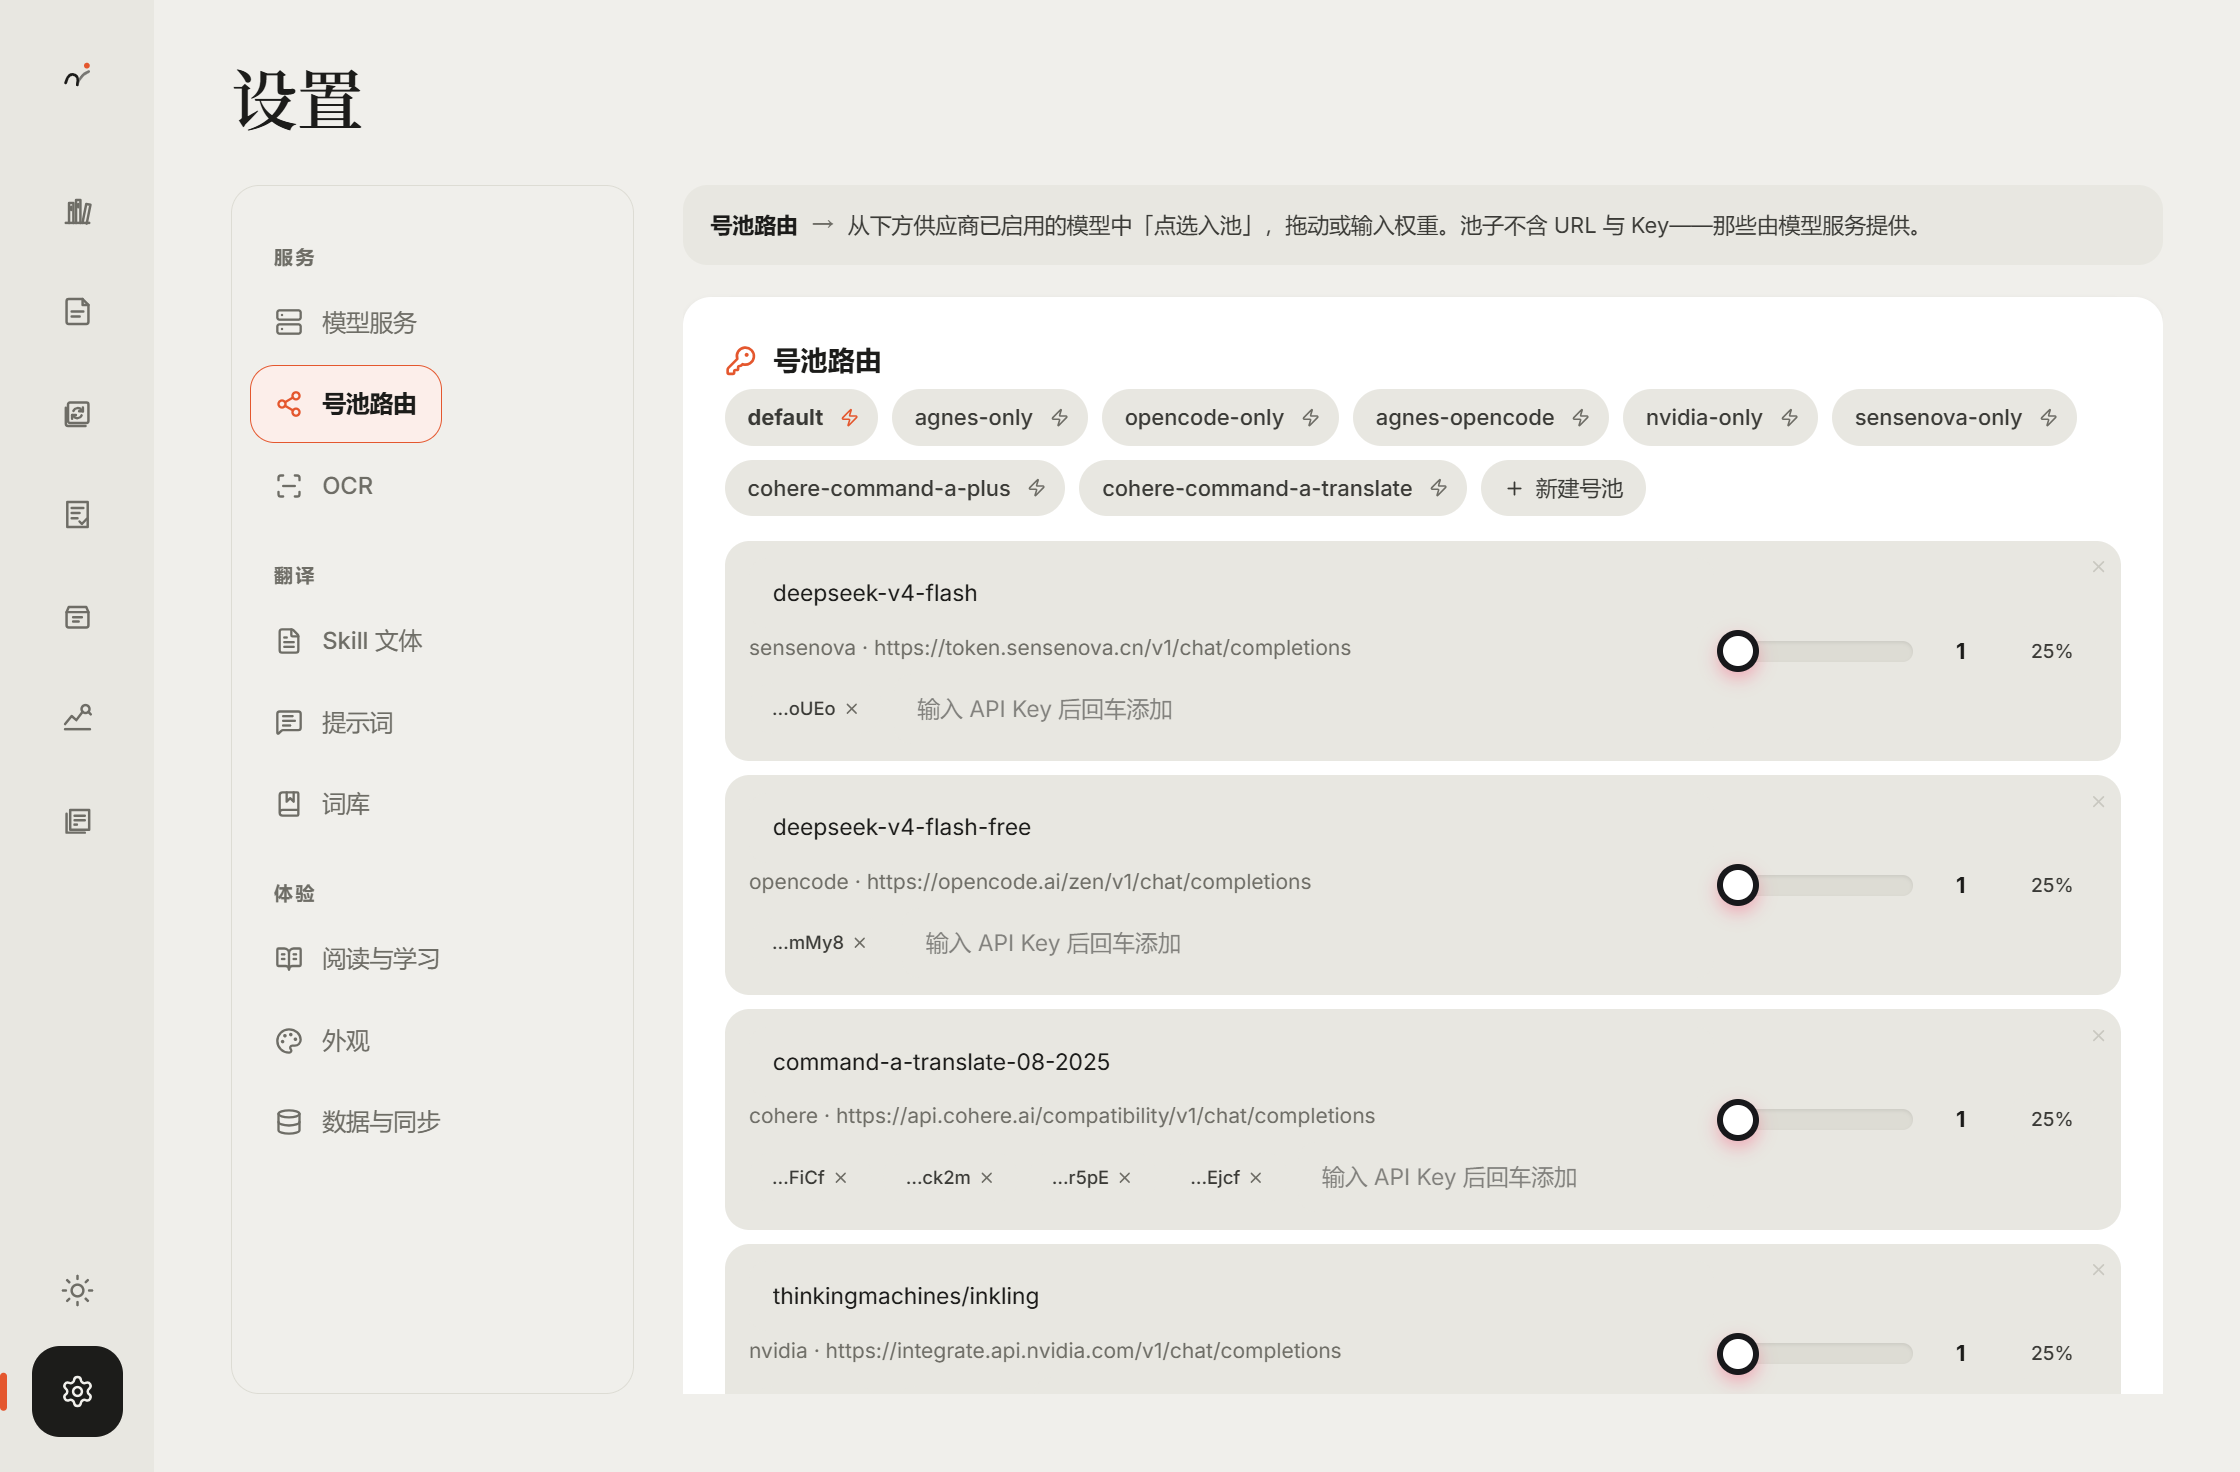
- 异步并发翻译:结构化 JSON 契约(translatedText + confirmedTerms);重试/退避/429 等待;provider 故障转移;checkpoint 断点恢复;route profile 跨任务复用指导动态限流与并发。
- 一致性修复:Wave 修补——后完成的 chunk 产出更稳术语后,对先完成 chunk 做最小回补(不重写整块),修补链路与主翻译分离、推理强度更低。
- 漏译复查:residual 英文复查——规则级掩码(避开 DOI/URL/Email/公式/参考文献/作者)→ 候选送修补模型 → 二次复查;统计入 metrics.json。
- 渲染:生成 translated.html;front matter 结构化结果渲染为译名标题、作者 hover 浮窗。
- 输出:工件 source.md / translated.md / translated.html / metrics.json / glossary.json / validation_report.json。
(全景见图 1。)
术语一致性:三个直觉方案的取舍(产品创意核心)
| 方案 | 代价 | 结论 |
|---|---|---|
| 译完再二次检查 | 多一遍全量 LLM,成本与延迟翻倍 | 否 |
| 先全量提术语再翻译 | 前置全量 NER,高成本、高延迟 | 否 |
| NER 预提取 + 首见锁定 + 译后回扫 | 预提取轻量、首见锁定保证一致、并发后回扫补漏 | 采用 |
关键在「动态术语进入正式资源层」:它被注入主翻译提示词、用于波次回补与最终一致性修正,并在 glossary.json 留下命中统计——命中高的动态术语可再提炼为静态术语表,形成正反馈。
译·读·学模块图(图 2)
翻译流水线 → 阅读器(双语对照 / 纯英+WordWise)→ 学习(按水平提取生词、复习),三者共享同一本书的工件与术语资源。
S4 开发与迭代
- 断点续跑 + 源文件哈希校验:checkpoint.json 保存 chunk 级译文、confirmed terms、阶段、glossary 冻结索引;中断恢复不重跑已完成 chunk,杜绝中断重复计费——这是「便宜 10–50%」的工程来源。
- route profile 跨任务复用:用前序成功/限流/并发错误样本指导后续动态限流与并发建议,新任务启动即加载画像,避免重复踩限流。
- 跨任务缓存:OCR raw 与 front matter 按内容哈希+契约缓存;命中只跳过 provider 调用,解析/重建/分块/渲染仍按当前代码重跑(缓存不掩盖代码演进)。
- 单章真实链路测试:
translate_epub_chapter_once让每次改动都能用真实章节快速验证,而非等整书跑完。 - 成本/速度:较传统翻译流便宜 10–50%、快 3–8 倍(图 4)。
S5 测评与护城河
- ~850 项 Rust 测试 + CI:流水线每个阶段都有回归底座。
- 真实门禁:working/20-regression-gates 下的 PDF 缓存与 route profile 真实门禁,改动必须过门。
- 漏译复查双层:规则掩码 + 修补模型 + 二次复查,统计落 metrics.json 与 validation_report.json。
- 人评黄金集(翻译质量):以短篇小说与学术论文做标注与问题诊断——我与 2 位朋友独立比较、标注问题,据此反哺翻译 prompt 与 skill 的完善,让人评闭环驱动生成质量迭代。
S6 交付与展望
- 已交付:Tauri 2 + React 19 + Rust 桌面应用;GitHub 开源(MIT);MSI/NSIS 安装包;双语 README + 12 张截图;多 provider(SenseNova/MiniMax/Cohere/NVIDIA/OpenAI-compatible)。
- 下一步:更多文体的人评与优化;动态术语→静态术语表的自动提炼;阅读与学习侧的深化(WordWise 卡片、insights)。